한 토큰씩 vs 한 번에 — 이 그림에서 맞는 칸과 틀리기 쉬운 칸
손으로 그린 그림 한 장을 받았다. 위 칸은 LLM, 아래 칸은 Jev 다.
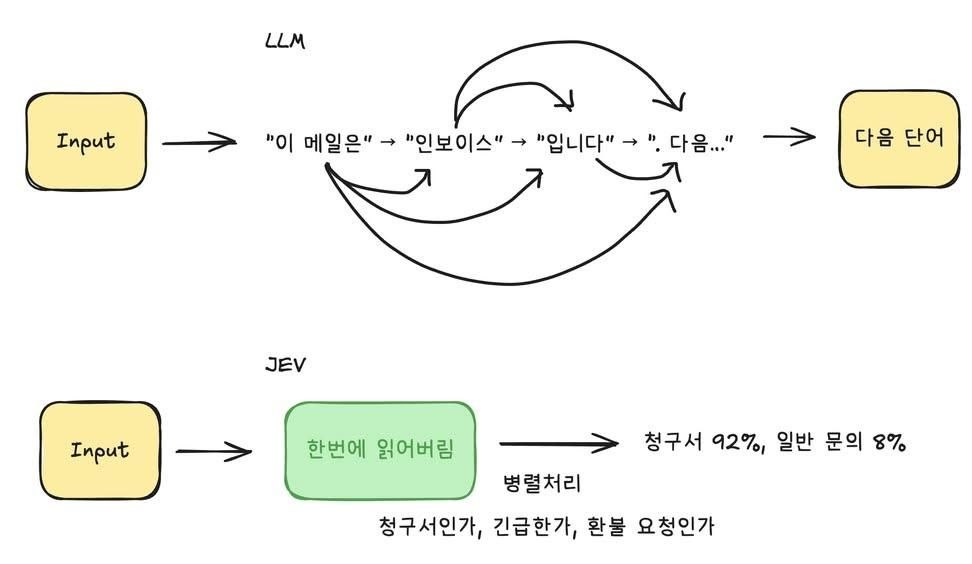
이 그림은 대체로 맞다. 그런데 한 칸이 조용히 틀리기 쉽다. 그 칸을 짚는 게 이 글의 목적이다.
1. 위 칸 — 되돌아가는 화살표는 은유가 아니다
그림에서 각 조각마다 뒤로 도는 곡선 화살표가 진짜 핵심이다. 이건 비유가 아니라 Transformer 추론의 정의 그대로다. Google 의 MLSys 2023 논문이 이렇게 적는다.
“generative inference proceeds one token at a time and the computation for each token sequentially depends on the previously generated tokens.” — Pope et al., Efficiently Scaling Transformer Inference1
그래서 출력 토큰 \(L_{\text{gen}}\) 개를 뽑으려면 모델 순전파를 \(L_{\text{gen}}\) 번 돌려야 한다. 같은 논문의 표현으로는 “a sequential loop of \(L_{\text{gen}}\) steps” 다.1 한 번 돌 때마다 가중치와 KV 캐시를 HBM 에서 연산 코어로 다시 실어 와야 하고, 논문은 그 시간을 “memory time” 이라 부르면서 긴 문맥에서는 KV 캐시를 옮기는 동안 연산 코어가 사실상 놀고 있다고 적는다.1
정리하면 위 칸의 비용은 생각의 난이도가 아니라 뱉는 글자 수에 비례한다. 분류 결과 한 개를
받으려고 {"category": "invoice"} 라는 껍데기까지 한 토큰씩 순차로 생성하는 것 — 그게 비용의
정체다.
2. 아래 칸 — “병렬”은 벤더가 직접 쓴 단어다
아래 칸의 “병렬처리” 는 내가 붙인 해설이 아니다. TypeSafe 런치 포스트의 비교표에 Sampling 행이 이렇게 있다.
Sampling — LLMs: “Sequential. Generates one token at a time, each conditioned on the last.” / Jev: “Parallel. Generates all outputs in a single query.” — Introducing System One Models and Jev, TypeSafe AI2
같은 글에 “a new model architecture, parallel sampler for maximum efficiency” 와, 쓰임새를 한 줄로 요약한 문장도 있다.
“Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.”2
그림 아래쪽의 “청구서 92%, 일반 문의 8%” 가 정확히 저 “typed probabilistic decisions” 다. 문자열이 아니라 스키마가 미리 정한 선택지 위의 분포가 한 번에 나온다. 그림 오른쪽 아래 “청구서인가, 긴급한가, 환불 요청인가” 도 맞는 그림이다 — 세 질문이 서로를 기다리지 않는다.
3. 틀리기 쉬운 칸 — “한번에 읽어버림”
초록 상자의 글귀가 그 한 칸이다. 이걸 “LLM 은 입력도 한 글자씩 읽고 Jev 는 한 번에 읽는다” 로 읽으면 틀린다. LLM 도 입력은 원래 한 번에 읽는다. 같은 논문이 그 단계를 이렇게 적어 놨다.
“Since the input tokens are all present at the start of the inference, we can run the model over all \(B \times L_{\text{input}}\) many tokens in parallel, in a single forwards pass over all the tokens. We call this step prefill.”1
즉 읽기(prefill)는 이미 병렬이고, 순차인 건 쓰기(decode)뿐이다. 그림의 위 칸에서 진짜로
느린 구간은 Input → 화살표가 아니라 "이 메일은" → "인보이스" → "입니다" 로 이어지는
오른쪽 절반이다.
그래서 저 초록 상자는 “읽기가 빨라졌다” 가 아니라 “쓰기를 없앴다” 로 읽는 게 맞다. Jev 가 빠른 이유는 남보다 잘 읽어서가 아니라 뱉을 글자가 애초에 없어서다. 벤더 자신도 그걸 포기라고 적는다 — “While Jev gives up string generation, it’s optimized for structured outputs”.2 그림으로 치면 위 칸의 곡선 화살표들을 지운 것이지, Input 화살표를 굵게 만든 게 아니다.
이 구분이 왜 중요하냐면, 입력이 길수록 이득이 줄어드는 게 아니라 출력이 짧을수록 이득이 커지는 구조이기 때문이다. 긴 문서를 넣고 라벨 하나를 받는 일이 제일 유리하고, 긴 답변을 받아야 하는 일은 애초에 아래 칸에 넣을 수 없다.
4. 그림에 안 그려진 칸 — 92% 라는 숫자
그림에서 제일 위험한 건 화살표가 아니라 숫자다. 92% 는 단순한 점수가 아니라
“이 값이 0.92 면 열에 아홉은 맞다” 라는 약속으로 읽히고, 사람들은 그 약속 위에
if p > 0.9: 자동처리 를 얹는다. 훈련 방법 이름부터가 Reinforcement Learning for
Calibrated Decisions 다.2
그런데 런치 포스트에는 그 약속을 뒷받침할 캘리브레이션 수치가 한 줄도 없다. 신뢰도 곡선도, ECE 도, Brier 스코어도 없다 — 이건 지난주에 전문을 받아 확인하고 따로 쓴 적이 있다: “Jev 가 LLM 보다 낫다” 에는 분모가 없다. 스키마를 벗어난 값을 못 뱉는 건 구조적 보장이 맞지만, 스키마 안의 틀린 칸을 92% 로 고르는 것은 그 보장이 막아주지 않는다.
그러니 그림의 아래 칸을 그대로 코드로 옮길 때 임계값은 벤더 숫자가 아니라 내 데이터에서 재서 정해야 한다. 재는 절차는 따로 적어 뒀다: 모르겠다고 말할 수 있는 모델.
5. 그래서 이 그림을 어디에 쓰나
그림은 두 모델의 우열표가 아니라 자리 배치도로 쓸 때 정확하다.
| 그림의 칸 | 실제로 대응하는 것 | 쓸 자리 |
|---|---|---|
| 위 칸 (곡선 화살표) | 자기회귀 디코딩 — 출력 토큰 수만큼 순전파 | 글·코드·설명처럼 문자열이 결과물인 일 |
| 아래 칸 (초록 상자) | 스키마 위 분포를 한 쿼리에 | if 문 자리 — 분류·라우팅·플래그 |
| 92% | 확신도 — 공개 검증 없음 | 임계값은 직접 측정 후 |
즉 대체재가 아니라 부품이다. 이 구도 자체는 처음 정리할 때 썼고 (Jev — 텍스트를 포기한 프런티어 모델), 실제 선택 사례에서도 결론은 같았다 (지연 로딩은 이미 하고 있다).
한 줄로 줄이면 — 위 칸의 비용은 읽는 데 있지 않고 쓰는 데 있다. 아래 칸은 그 쓰기를 없앤 것이고, 없앤 대가로 글을 못 쓴다.
근거의 한계
- 위 칸의 순차성과 prefill 병렬성은 동료심사 논문(MLSys 2023) 근거다. 다만 그 논문은 PaLM 540B / TPU v4 기준이라, 수치(29ms/토큰 등)는 인용하지 않고 구조적 서술만 가져왔다.
- 아래 칸의 “병렬 샘플링” 은 전부 벤더 1차 주장이다. Jev 의 모델 구조·파라미터 수·가중치는 공개되지 않았고, RLCD 는 이름만 공개돼 있어 알고리즘으로 평가할 수 없다. 즉 “한 쿼리에 전부 생성” 이 내부적으로 어떻게 이뤄지는지는 검증 불가다.
- 92% 같은 확신도 값의 신뢰성을 보여주는 중립 제3자 캘리브레이션 측정은 찾지 못했다. 그림의 그 숫자는 예시이지 측정치가 아니다.
- 이 글은 속도·가격 배수를 일부러 하나도 쓰지 않았다. 그 숫자들의 분모 문제는 별도 글에서 다뤘다.3
References
-
Reiner Pope, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Anselm Levskaya, Jonathan Heek, Kefan Xiao, Shivani Agrawal, Jeff Dean, “Efficiently Scaling Transformer Inference”, Proceedings of the 6th MLSys Conference, 2023. https://proceedings.mlsys.org/paper_files/paper/2023/file/c4be71ab8d24cdfb45e3d06dbfca2780-Paper-mlsys2023.pdf (arXiv preprint https://arxiv.org/abs/2211.05102) ↩ ↩2 ↩3 ↩4
-
“Introducing System One Models and Jev”, Diogo Almeida (founder, TypeSafe AI), 2026-09. https://typesafe.ai/blog/introducing-system-one-models-and-jev ↩ ↩2 ↩3 ↩4
-
본 블로그, “Jev 가 LLM 보다 낫다” 에는 분모가 없다, 2026-09-22. ↩