지연 로딩은 이미 하고 있다 — jev-skill-suggestion 이 실제로 들어내는 것은 '목록'이다
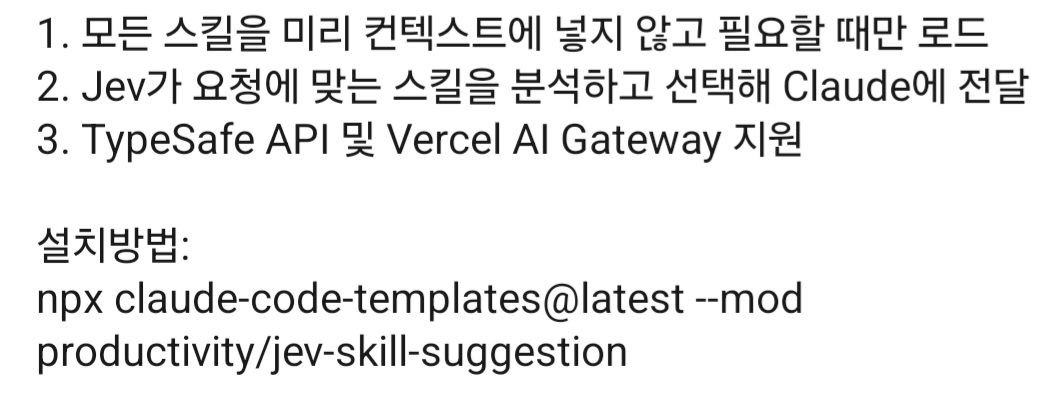
위 세 줄을 그대로 옮기면 이렇다.
- 모든 스킬을 미리 컨텍스트에 넣지 않고 필요할 때만 로드
- Jev 가 요청에 맞는 스킬을 분석하고 선택해 Claude 에 전달
- TypeSafe API 및 Vercel AI Gateway 지원
설치 한 줄은 npx claude-code-templates@latest --mod productivity/jev-skill-suggestion 이고,
claude-code-templates 는 davila7 이 유지하는 Claude Code 설정 모음 CLI 다.1
솔깃한 요약인데, 1번은 이미 Claude Code 가 하고 있는 일이다. 이 글은 그 오해를 걷어내고 이 mod 가 진짜로 바꾸는 한 가지가 무엇인지, 그리고 공개된 측정치를 이 물건의 성능으로 읽으면 왜 안 되는지를 적는다.
1. 스킬 본문은 원래 안 올라간다
Anthropic 공식 문서가 이 부분은 분명하다. 스킬 디렉터리의 SKILL.md 는 YAML front matter 에
name 과 description 을 요구하고, 엔진은 기동 시점에 설치된 모든 스킬의 이 두 필드만
시스템 프롬프트에 올린다. 본문은 그때 올라가지 않는다.
“Claude loads this metadata at startup and includes it in the system prompt. … until a Skill is triggered, only its name and description occupy context.” — Agent Skills, Claude Platform Docs2
Anthropic 엔지니어링 블로그도 같은 말을 한다. 메타데이터가 progressive disclosure 의 첫 단계고,
본문은 그 스킬이 지금 과제에 관련 있다고 판단될 때 SKILL.md 를 통째로 읽어 들이는 두 번째
단계다.3 참조 파일(FORMS.md 같은)은 세 번째 단계라 본문이 그걸 가리킬 때만 또 읽는다.
스크립트는 아예 컨텍스트에 안 들어가고 실행 결과만 들어온다.2
그러니 “모든 스킬을 미리 컨텍스트에 넣지 않는다” 는 mod 의 기능이 아니라 플랫폼의 기본 동작이다. 스킬을 100개 깔아도 100개의 본문이 올라가지는 않는다.
남는 건 목록이다. 스킬 하나당 한 줄, 설치된 전부. 이건 프롬프트가 스킬과 아무 상관이 없어도 매 세션 올라간다. mod 가 들어내는 건 정확히 이것이다. 제품 페이지의 표현이 오히려 정직하다.
“what goes away is the listing Claude Code sends the model every session — one line per skill, sixty-odd lines on a well-equipped machine — whether or not the prompt has anything to do with any of them” — jev-skill-suggestion, AI Templates4
2. 그 목록은 얼마나 드는가 — 내 맥에서 실측
말로만 “sixty-odd lines” 라고 하면 감이 안 오니 이 글을 쓰는 맥에서 직접 셌다.
# 개인 스킬 디렉터리의 name/description 두 줄만 뽑아 센다
cd ~/.claude/skills
for f in */SKILL.md; do
  awk '/^---/{n++; next} n==1 && /^(name|description):/{print}' "$f"
done | wc -lc
| 대상 | 수 |
|---|---|
~/.claude/skills 개인 스킬 |
57 개 |
그 스킬들의 name+description |
114 줄, 20,982 바이트 |
플러그인 포함 디스크상의 전체 SKILL.md |
251 개 |
토큰 수는 적지 않는다. 토크나이저에 따라 달라지고, 내 설명문은 한글이라 UTF-8 에서 글자당 3바이트씩 먹어 바이트→토큰 환산이 영어 기준과 다르다. 확인 가능한 건 바이트뿐이라 바이트만 적는다. 다만 2만 바이트가 프롬프트 내용과 무관하게 매 세션 상주한다는 사실은 그대로다. (251개가 전부 한 세션에 올라간다는 뜻은 아니다. 활성화된 것만 목록에 들어간다.)
3. 그런데 진짜 문제는 용량이 아니다
용량만 문제라면 답은 “스킬을 덜 깔아라” 다. 이 mod 가 겨냥하는 건 다른 쪽이다.
목록은 한 줄이라 설명이 잘린다. 잘리면 비슷한 스킬이 구분되지 않는다. 쿡북 해설이 든 예가 좋다 — 쿡북이 쓴 에이전트 런너 Hermes 는 설명을 기본 60자로 자르는데, 그 폭에서는 PowerPoint 파일을 편집하는 스킬과 작성하는 스킬이 거의 같은 문장이 된다.5 발표자료를 만들어 달라고 하면 엉뚱한 쪽이 로드된다.
TypeSafe 는 이걸 자기네 쿡북에서 실제로 쟀다. Nous Research 의 Hermes 카탈로그 182개 스킬,
488개 요청, 에이전트는 claude-haiku-4-5-20251001, 랭킹은 jev-1.12, 실행일 2026-07-31.6
| 엉뚱한 스킬을 로드 | 맞는 게 없는데 로드 | |
|---|---|---|
| 에이전트 단독 (목록만 보고) | 16.8% | 9.8% |
| + TypeSafe 제안 한 줄 | 7.3% | 4.0% |
| 정답을 그냥 손에 쥐여준 경우 | 2.5% | 1.2% |
세 번째 행이 이 표에서 제일 중요하다. 정답을 알려줘도 0%가 안 된다. 에이전트는 맞는 스킬을 받고도 그걸 로드하지 않을 때가 있고, 선택 기법이 아무리 좋아도 그 바닥 밑으로는 못 간다. 그러니 개선 폭을 볼 때 분모는 16.8%가 아니라 \(16.8 - 2.5 = 14.3\) 퍼센트포인트다. 그 중 \(16.8 - 7.3 = 9.5\) 포인트를 줄였으니 도달 가능한 여지의 약 2/3 를 먹은 셈이다. 쿡북 자신도 “most of the gap between guessing from a truncated index and being handed the answer” 라고 쓴다.6
4. 쿡북이 스스로 밝힌 반대편
여기서 멈추면 광고가 된다. 같은 쿡북에 이런 줄이 있다.
“of 315 covered requests: 37 the suggestion fixed, 7 it broke”6
제안을 붙였더니 원래 맞히던 7건이 틀리게 됐다. 확신에 찬 틀린 힌트는 힌트가 없는 것보다 더 잘 따라가진다. 쿡북이 게이트 임계값을 두고, 제안을 “무시해도 되는 한 줄” 로 주입하는 이유가 이것이다.6 순증 30건이 이득이긴 하지만, 7건은 새로 만들어낸 실패다. 없던 실패 모드가 생겼다는 뜻이라 총계로만 읽으면 안 된다.
confidence 를 임계값으로 쓰는 얘기는 전에 따로 썼다 — 모르겠다고 말할 수 있는 모델. Jev 가 애초에 왜 텍스트를 포기했는지는 Jev — 텍스트를 포기한 프런티어 모델.
5. 쿡북과 mod 는 같은 물건이 아니다 — 이 글의 요점
이게 제일 중요한 대목이다. 위 숫자를 낸 설계와, npx 로 깔리는 설계가 다르다.
쿡북 쪽은 의도적으로 약하게 만들어져 있다.
“the cookbook’s answer is deliberately weak: one extra line in the system prompt naming the winner, with the agent told to ignore it if it does not fit. The roster itself never changes, so any prefix caching over it still holds. Nothing is loaded automatically.”5
즉 쿡북은 (ㄱ) 목록을 그대로 두고 (ㄴ) 한 줄만 덧붙이고 (ㄷ) 자동 로드를 하지 않는다. prefix 캐시가 유지되는 것도 목록을 안 건드리기 때문이다.
mod 는 셋 다 반대로 간다. 제품 페이지 기준으로 목록을 컨텍스트에서 들어내고(hideListing),
고른 스킬의 SKILL.md 를 직접 프롬프트에 붙이고(inject), /jev-skill-suggestion:setup 은
스킬들을 user-invocable-only 로 돌려 모델에게서 아예 감춘다.4
| 쿡북 (측정된 것) | mod (설치되는 것) | |
|---|---|---|
| 스킬 목록 | 그대로 둔다 | 컨텍스트에서 제거 |
| 제안의 성격 | 무시 가능한 한 줄 | 직접 로드 |
| 틀렸을 때 | 에이전트가 뒤집을 수 있음 | 뒤집을 목록 자체가 없음 |
| prefix 캐시 | 유지됨 | 목록이 바뀌므로 해당 없음 |
쿡북 해설이 이 위험을 먼저 적어 놨다 — “A router that forces a load turns a 7.3% error into a hard failure.”5 7.3%는 에이전트가 뒤집을 수 있는 상태에서 나온 숫자다. 목록을 치우면 7.3%는 회복 불가능한 실패가 된다. 그러니 16.8%→7.3% 를 이 mod 의 성능으로 인용하는 건 틀렸다. 그 수치는 이 mod 가 아닌 다른 설계에서 나왔다. mod 자체의 중립적 측정치는 찾지 못했고, 제품 페이지도 쿡북 수치를 그대로 인용할 뿐 자체 수치를 제시하지 않는다.4
6. 돌리기 전에 알아야 할 운영 조건
제품 페이지에 적힌 제약이 가볍지 않다.4
- Early access. mod 는 Anthropic 의
mods/레이아웃 위에 function hooks 로 만든 플러그인이고,$API 는 릴리스 사이에 바뀔 수 있다고 명시돼 있다. - Claude Code 2.1.259+ 에서
CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1이 있어야 로드된다. 플래그가 없으면 디버그 로그에 rollout flag is off 로 조용히 빠진다. --mod는 프로젝트의.claude/skills/에 쓰는데, 그 폴더는 리포 콘텐츠라 신뢰(trust)하기 전에는 읽히지 않는다. 헤드리스 실행(-p)은 신뢰 프롬프트를 띄우지 않으므로 영영 못 본다.- 백엔드는 키에 따라 갈린다. TypeSafe API(
POST api.typesafe.ai/v1/systemone,jev-latest)는 답마다 보정된 confidence 를 보고하고, Vercel AI Gateway (POST ai-gateway.vercel.sh/v4/ai/evaluation-model,typesafe-ai/jev)는 선택적 분포에서 유도한다. 둘 다 있으면 TypeSafe 쪽이 이긴다. - 키가 하나도 없어도 동작한다. 엔진 자체의 내장 분류기로 폴백한다. 이때는 게이트가 없다 — 즉 “아무 스킬도 필요 없다” 를 판정하는 단계가 빠진다.
그리고 프롬프트마다 요청이 두 번 나간다(전체 랭킹 1회 + 상위 3개 정밀 재검토 1회).
기본 timeoutMs 는 그 지연 예산이다. 공짜가 아니다.
7. 그래서 켤까
판단 기준은 스킬 개수 하나로 충분하지 않다. 세 개로 나눠 보는 게 낫다.
- 목록이 실제로 큰가. 위
awk한 줄로 바이트를 세 본다. 스킬이 열 개 남짓이면 이 mod 가 해결할 문제 자체가 없다. - 설명이 잘려 구분이 안 되는 쌍이 있는가. 없으면 16.8% 같은 오적재율이 애초에 안 난다. 있는지 없는지는 세지 말고 읽어 봐야 안다.
- 틀린 선택을 에이전트가 뒤집을 수 있어야 하는가. 그렇다면 목록을 들어내는 설정
(
hideListing,inject)은 켜지 않는 게 맞다. 쿡북이 측정한 약한 형태에 가깝게 쓰는 셈이다.
그리고 제일 정직한 방법은 남의 숫자를 인용하지 않는 것이다. 쿡북은 표를 만든 하니스를 그대로 공개해 두고 “ready to point at your own roster” 라고 적어 놨다.6 내 로스터에서 내가 재는 게 182개짜리 남의 카탈로그 수치보다 낫다.
근거의 한계
- 16.8%→7.3%, 9.8%→4.0% 는 TypeSafe 자신이 자기 제품을 쟀고 자기 문서에 실은 수치다. 벤더 1차 벤치마크로 읽어야 한다. 다만 하니스·로스터·요청 집합이 함께 공개돼 재현 경로가 있다는 점은 보통의 마케팅 수치와 다르다.
- 중립 제3자의 독립 재현은 찾지 못했다. 검색에 걸리는 글들은 대부분 같은 쿡북의 같은 표를 옮긴 2차 자료다.
- 측정에 쓰인 에이전트는
claude-haiku-4-5-20251001한 종이고 로스터는 Hermes 182개 하나다. 다른 모델·다른 로스터로 일반화되는지는 그 실험이 답하지 않는다. - 반복 실행의 분산(신뢰구간)이 문서에 없어 9.5 포인트 차가 통계적으로 얼마나 단단한지는 이 자료만으로 말할 수 없다.
- mod 자체의 측정치는 어디에도 없다. 5절에서 적었듯 mod 는 측정된 설계와 다르게 동작한다.
- 이 글의 20,982 바이트·57개·251개는 2026-09-22 기준 내 맥 한 대의 값이다. 남의 기계에 그대로 옮겨 쓸 수치가 아니다.
References
-
davila7/claude-code-templates, GitHub. https://github.com/davila7/claude-code-templates ↩
-
Agent Skills — Overview, Claude Platform Docs (Anthropic). https://platform.claude.com/docs/en/agents-and-tools/agent-skills/overview ↩ ↩2
-
“Equipping agents for the real world with Agent Skills”, Anthropic Engineering, 2025-10-16. https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills ↩
-
“Jev Skill Suggestion — Mods for Claude Code”, AI Templates (davila7/claude-code-templates). https://www.aitmpl.com/component/mods/productivity/jev-skill-suggestion ↩ ↩2 ↩3 ↩4
-
“Agent routing and skill selection with System One models”, systemonemodels.org. https://systemonemodels.org/use-cases/real-time-and-agents/agent-routing-and-skill-selection/ ↩ ↩2 ↩3
-
“Skill suggestion” cookbook, TypeSafe Docs. 182-skill Hermes roster, 488 requests,
claude-haiku-4-5-20251001,jev-1.12, rendered 2026-07-31. https://docs.typesafe.ai/cookbooks/skill_suggestion ↩ ↩2 ↩3 ↩4 ↩5