[팹 IoT 연구 5] 공개 실데이터로 해 보기 — SECOM 은 왜 안 맞고, WM-811K 는 왜 잘 맞나, 그리고 둘을 MQTT 로 묶기
1~4편은 전부 합성 데이터였다. 이번 편은 공개된 실제 반도체 데이터 두 개를 쓴다 — 공정 센서 기록(SECOM)과 웨이퍼 맵(WM-811K). 다만 둘은 출처가 서로 다른 데이터라 같은 웨이퍼로 이어 붙일 수 없다. 3절의 “묶기”는 한 관제 파이프라인에서 두 라인을 동시에 돌린다는 뜻이지, 식각 기록과 검사 결과를 웨이퍼 단위로 연결했다는 뜻이 아니다.
연구 질문
- 공정 센서만으로 최종 불량(pass/fail)을 미리 맞힐 수 있나? (SECOM)
- 웨이퍼 맵의 불량 모양은 작은 CNN 으로 얼마나 구분되나? (WM-811K)
- 두 모델을 MQTT 위에 올려 장비 → 탐지 → lot 출하 보류까지 한 줄로 흘리면 어떻게 동작하나?
실험은 홈랩 k3s 클러스터의 데스크톱 노드 한 대(6코어 i5-8500, 16GB, GTX 1060 3GB)에서 돌렸다.
이 노드는 etcd 투표 노드이기도 해서, 무거운 작업은 전부 systemd-run --user --scope -p MemoryMax=… 로 메모리 상한을 따로 걸고 돌렸다.
1. SECOM — 공정 센서로 불량 예측: 거의 안 맞는다
데이터
UCI SECOM 은 “Data from a semi-conductor manufacturing process” 로 소개된 공개 데이터다.
UCI 페이지 기준 1,567건, 그중 불량(fail) 104건이고 결측값이 있다(CC BY 4.0, McCann & Johnston, 2008).
내려받은 secom.data 는 센서 열이 590개였고, 라벨·타임스탬프는 secom_labels.data 에 따로 있다.
불량 비율은 6.6% 다.
설계 — 시간순으로 자른다
공장에서는 과거 데이터로 미래를 예측한다. 그래서 타임스탬프로 정렬한 뒤 앞 70%(2008-07-19 ~ 09-26, 1,096건, 불량 78)로 학습, 뒤 30%(09-26 ~ 10-17, 471건, 불량 26)로 평가했다. 결측 50% 초과 열과 상수 열은 학습 구간만 보고 걸러서 444개 센서가 남았다. 결측은 학습 구간 중앙값으로 채웠다.
모델은 세 가지 — 로지스틱 회귀(클래스 가중), LightGBM(불균형 가중), 정상만으로 학습한 Isolation Forest. 불량이 드물어서 정확도는 보지 않고, ROC-AUC 와 PR-AUC(평균정밀도)를 본다. PR-AUC 는 무작위 분류기라면 불량 비율과 같으니(이번 평가 구간 0.055) 그 숫자와 나란히 놓는다.
결과
| 모델 | ROC-AUC | PR-AUC | 불량 50% 를 잡을 때 정상 중 잘못 거르는 비율 |
|---|---|---|---|
| 로지스틱 회귀 | 0.594 | 0.070 | 35.5% |
| LightGBM | 0.544 | 0.067 | 44.5% |
| Isolation Forest (비지도) | 0.482 | 0.052 | 44.9% |
| (참고) LightGBM, 무작위 5-fold CV | 0.678 | 0.138 | — |
LightGBM 의 시간순 AUC 0.544 에 부트스트랩(2,000회)으로 95% 신뢰구간을 내면 [0.433, 0.659] 다 — 0.5(동전 던지기)를 포함한다. 평가 구간 불량이 26건뿐이라 불확실성이 크다는 점도 같이 읽어야 한다.
해석 — 같은 모델, 다른 분할, 다른 숫자
시간을 무시하고 무작위로 섞어 평가하면 AUC 가 0.68 로 올라간다. 모델은 같고 분할만 바뀌었다. 가장 그럴듯한 설명은 공정이 시간에 따라 변한다(드리프트)는 것이다. 무작위 분할에서는 평가 구간과 같은 시기의 데이터가 학습에 섞여 들어가 그 시기의 특징을 미리 보게 된다. → SECOM 으로 높은 정확도를 보고하는 글을 볼 때는 분할을 시간순으로 했는지부터 확인해야 한다.
실무적으로는 이렇게 읽었다: 최종 불량은 여러 공정 단계·계측·검사가 누적된 결과라, 한 지점의 센서 요약값만으로는 잘 안 보인다. 그래서 FDC(장비 이상 감지)는 “불량 예측기”라기보다 “장비 상태 감시”로 쓰고, 그 뒤에 계측·검사 데이터를 붙이는 구조가 된다(4편의 가상 계측과 이어지는 지점).
2. WM-811K — 웨이퍼 맵 불량 패턴 분류: 잘 맞는다
데이터
WM-811K 는 Wu, Jang, Chen 의 논문(IEEE Trans. Semiconductor Manufacturing 28(1), 2015, doi:10.1109/TSM.2014.2364237)에서 쓴 웨이퍼 맵 모음이다.
흔히 쓰는 LSWMD.pkl(2,095,505,977 바이트)을 받아 보니 웨이퍼 811,457장이 들어 있었고, 그중 패턴 라벨이 붙은 건 172,950장이었다.
맵 값은 0(웨이퍼 밖) / 1(정상 다이) / 2(불량 다이)다.
| 패턴 | 장수 | 패턴 | 장수 | |
|---|---|---|---|---|
| none | 147,431 | Loc | 3,593 | |
| Edge-Ring | 9,680 | Scratch | 1,193 | |
| Edge-Loc | 5,189 | Random | 866 | |
| Center | 4,294 | Donut | 555 | |
| Near-full | 149 |
none 이 85% 라, 전부 none 이라고만 찍어도 정확도가 85% 가까이 나온다. 그래서 주 지표는 macro-F1(9개 패턴을 같은 무게로 평균)이다.
손질한 것들:
- 이 피클은 Python 2 시절 객체라 최신 pandas 의
read_pickle로는 안 열렸다.pickle.load(f, encoding="latin1")로 풀었다. - 웨이퍼마다 맵 크기가 달라 최근접 보간으로 32×32 로 맞췄다. 선형 보간을 쓰면 0/1/2 사이 값이 생겨 의미가 깨진다.
- 0/1/2 는 크기가 아니라 범주라 3채널 one-hot 으로 넣었다.
설계 — lot 단위로 자른다
같은 lot 의 웨이퍼는 서로 닮았다. 웨이퍼 단위로 무작위 분할하면 같은 lot 이 학습·평가에 동시에 들어가 점수가 부풀려진다.
그래서 scikit-learn 의 GroupShuffleSplit 으로 lot 단위 70/10/20 분할을 했다
(학습 121,231장·7,532 lot / 검증 17,272장 / 평가 34,447장·2,153 lot, lot 겹침 없음을 코드로 확인).
모델은 3단 합성곱(32→64→128 채널) + 작은 분류기. 손실은 클래스 빈도의 제곱근 역수로 가중했고, 결함 패턴은 방향과 무관하다고 보고 90° 회전·좌우 뒤집기로 증강했다. 20 에폭, 검증 macro-F1 이 가장 좋은 시점의 가중치를 썼다. GTX 1060 3GB 에서 약 14분, GPU 메모리 최대 1.7GB.
결과 (평가: 학습에 안 쓴 2,153 lot)
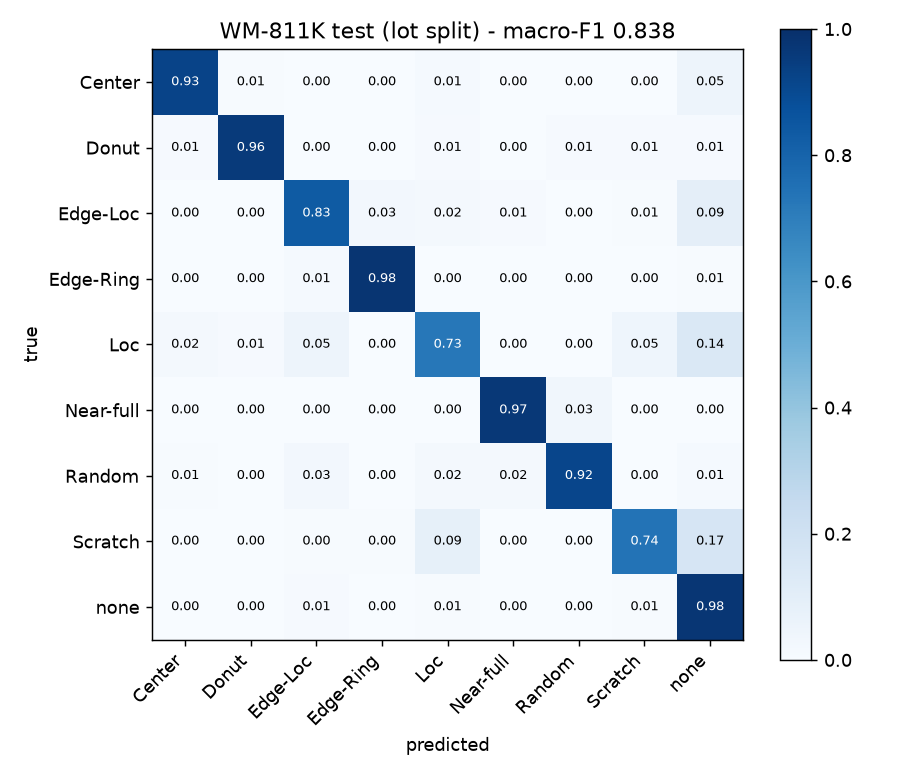
macro-F1 0.838, 정확도 0.962 (전부 none 기준선 0.855).
| 패턴 | 정밀도 | 재현율 | F1 |
|---|---|---|---|
| Edge-Ring | 0.942 | 0.978 | 0.960 |
| Random | 0.923 | 0.917 | 0.920 |
| Donut | 0.872 | 0.959 | 0.913 |
| Center | 0.882 | 0.925 | 0.903 |
| Near-full | 0.707 | 0.967 | 0.817 |
| Edge-Loc | 0.735 | 0.833 | 0.781 |
| Loc | 0.717 | 0.725 | 0.721 |
| Scratch | 0.437 | 0.740 | 0.549 |
| none | 0.990 | 0.975 | 0.982 |
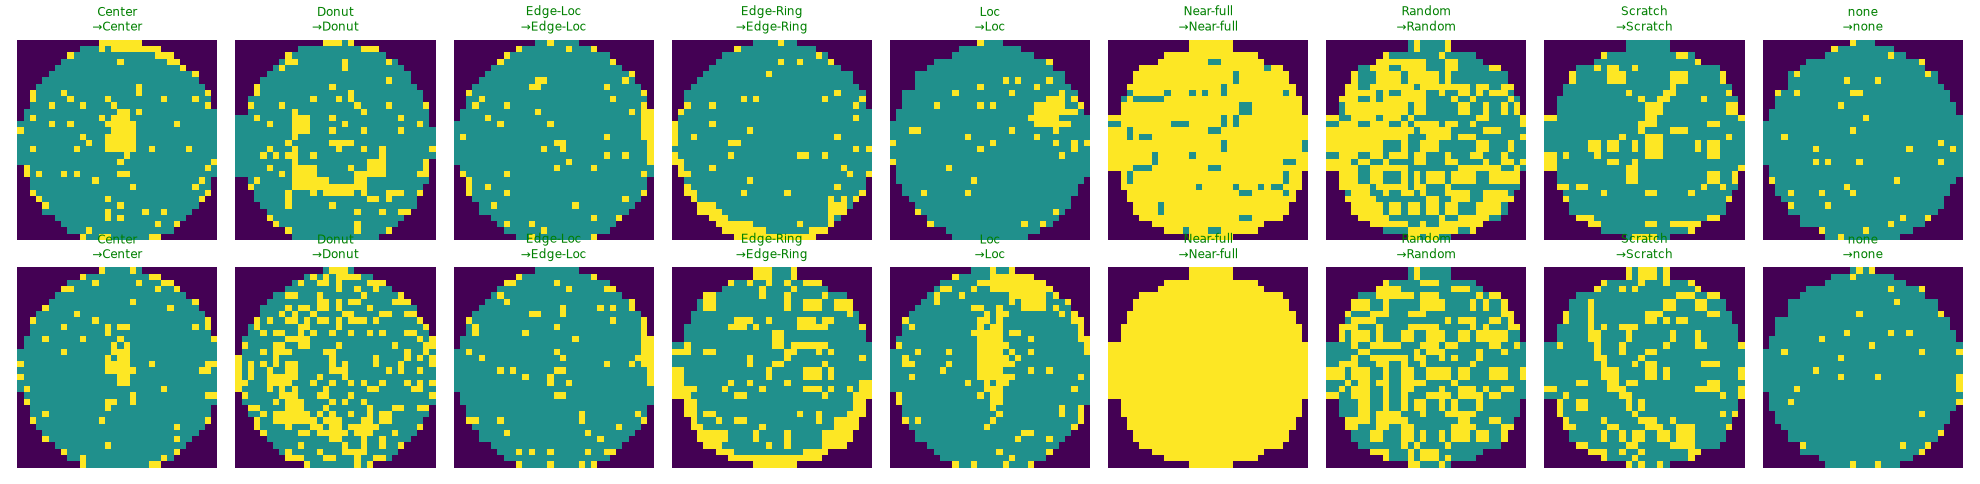
약점은 Scratch 다. 가는 선이라 32×32 로 줄이면서 정보가 많이 사라지고, Loc·none 과 헷갈린다(혼동행렬에서 Scratch 의 17% 가 none 으로 갔다). 해상도를 올리는 게 다음 실험 후보다.
왜 1절과 이렇게 다른가
웨이퍼 맵은 결과(불량 다이의 위치)를 직접 본다. 패턴이 공간적으로 뚜렷하면 작은 CNN 으로도 충분하다. 반면 SECOM 은 원인 쪽(공정 센서)에서 결과(최종 판정)를 간접적으로 추정해야 하고, 그 관계가 시간에 따라 변한다. 같은 “반도체 불량 문제”라도 난이도가 전혀 다르다.
3. 두 라인을 MQTT 로 묶기
구성
클러스터에서 이미 돌고 있는 Eclipse Mosquitto 브로커에, 기존 토픽과 섞이지 않게 fablab/fab1/* 아래로만 올렸다.
[ETCH01 식각 장비]  SECOM 평가 구간 471건을 실제 기록 그대로 재생
   └─ tool/ETCH01/event (PROCESS_START/END)  ·  tool/ETCH01/run (센서 590채널)
        → [FDC 탐지기] LightGBM 점수 → fdc/ETCH01/score, alarm

[INSP01 검사 장비]  WM-811K 평가 구간의 처음 120 lot(1,710장)을 lot 순서대로 재생
   └─ tool/INSP01/event (LOT_START/END)  ·  tool/INSP01/wafermap (32×32 uint8 → base64)
        → [웨이퍼 분류기, GPU] → fdc/INSP01/pattern, alarm

[팹 모니터]  fdc/# 와 장비 이벤트를 함께 구독
   └─ lot 이 끝나고 그 lot 의 분류 결과가 다 모이면,
      불량 패턴 웨이퍼 비율 ≥ 30% → mes/lot/<lot>/hold  (MES 의 출하 보류를 흉내)
장비 이벤트는 SECS/GEM 의 Collection Event 를 흉내만 낸 JSON 이다. GEM 은 SEMI E30 으로 표준화돼 있고, 초록은 “GEM defines a standard implementation of SECS-II for all semiconductor manufacturing equipment” 라고 설명한다(SEMI E30). 표준 본문은 유료라 읽지 않았고, 메시지 구조는 표준을 따르지 않는다(실제 게이트웨이 시도는 3편).
정답 라벨은 truth/* 토픽으로 따로 흘려서 채점에만 썼다. 탐지기와 분류기는 이 토픽을 판단에 쓰지 않는다.
결과 (두 장비 동시 재생, 한 번 실행)
| 항목 | 값 |
|---|---|
| ETCH01 FDC | 471건 전부 점수화, 알람 211건, 실제 불량 13/26 포착, AUC 0.544 (오프라인과 동일) |
| INSP01 분류 | 1,710장 전부 분류, 웨이퍼 정확도 0.985, 불량 웨이퍼 재현율 0.990, 정상 오판 0.8% |
| 지연 (발행 → 결과) | 웨이퍼 분류 p50 1.8ms (그중 GPU 추론 1.3ms), FDC p50 7.1ms |
| lot 출하 보류 | 120 lot 중 보류 59건 — 전부 정답(정밀도 1.000), 놓친 lot 2건(재현율 0.967) |
| 메시지 유실 | 없음 (장비 이벤트 수 = 발행 수) |
스트리밍으로 받은 FDC 점수의 AUC 가 오프라인 평가와 같다는 건, 파이프라인(직렬화·전송·역직렬화)이 데이터를 바꾸지 않았다는 확인이다.
이 숫자를 그대로 믿으면 안 되는 이유
- 이번 120 lot 의 웨이퍼 정확도(0.985)는 평가 구간 전체(0.962)보다 높다. 고른 구간이 상대적으로 쉬웠다.
- 이 데이터의 라벨 붙은 lot 은 “거의 다 정상” 아니면 “거의 다 불량”으로 갈려 있다(평가 구간 lot 불량 비율의 중앙값 0.09, 75% 분위수 1.0). 그래서 lot 보류 판단은 원래 쉬운 문제다. 실제 팹은 경계에 걸친 lot 이 더 많을 것이다.
- 1절의 FDC 는 그대로 약하다. 파이프라인이 빠르고 정확해도, 모델이 약하면 알람은 대부분 오알람이다(211건 중 198건).
한계
- SECOM 과 WM-811K 는 서로 다른 출처라 웨이퍼 단위로 연결하지 못했다. “식각 이상 → 그 웨이퍼의 검사 결과로 확인” 같은 진짜 인과 연결은 웨이퍼 추적이 되는 데이터가 있어야 가능하다.
LSWMD.pkl은 원 연구실 링크가 응답하지 않아, Kaggle 판과 바이트 수가 같은 Hugging Face 공개 미러에서 받았다. 원본과의 동일성은 바이트 수와 미러의 SHA-256 으로만 확인했다.- SECOM 평가 구간 불량은 26건뿐이다. AUC 신뢰구간이 넓다.
- 하이퍼파라미터는 거의 손대지 않았다. 평가 구간을 보고 튜닝하면 1절의 교훈(부풀려진 평가)을 스스로 반복하게 된다.
- 한 번 실행한 결과다. 시드를 바꾼 반복 실험은 하지 않았다.
재현 메모
- Python 3.12 가상환경에 PyTorch 2.14(CUDA 12.6 빌드). GTX 1060(Pascal)에서 실제 행렬 연산이 돌아가는 것까지 확인했다.
- PyTorch 2.6 부터
torch.load의weights_only기본값이 바뀌었다(PyTorch 2.6 릴리스 블로그; 현재 문서 서명은weights_only=True, torch.load). 체크포인트에 NumPy 문자열 같은 객체를 넣어 저장했더니 불러오기가 거부됐다. 클래스 이름을 순수str로 바꿔 저장해서 해결했다 —weights_only=False로 우회하지 않았다. - 실행 순서:
secom/train_secom.py→wafer/convert_wm811k.py→wafer/train_wafer_cnn.py→iotsim/run_fab.sh(소비자 3개가 브로커에 붙은 걸 확인한 뒤 장비 2대를 동시에 재생).
References
- M. McCann, A. Johnston, SECOM [Dataset], UCI Machine Learning Repository, 2008. doi:10.24432/C54305. https://archive.ics.uci.edu/dataset/179/secom
- M.-J. Wu, J.-S. R. Jang, J.-L. Chen, “Wafer Map Failure Pattern Recognition and Similarity Ranking for Large-Scale Data Sets,” IEEE Transactions on Semiconductor Manufacturing 28(1), pp. 1–12, 2015. doi:10.1109/TSM.2014.2364237
- G. Ke, Q. Meng, T. Finley, T. Wang, W. Chen, W. Ma, Q. Ye, T.-Y. Liu, “LightGBM: A Highly Efficient Gradient Boosting Decision Tree,” Advances in Neural Information Processing Systems 30 (NIPS 2017). https://papers.nips.cc/paper/2017/hash/6449f44a102fde848669bdd9eb6b76fa-Abstract.html
- LightGBM Documentation. https://lightgbm.readthedocs.io/
- F. T. Liu, K. M. Ting, Z.-H. Zhou, “Isolation Forest,” Proc. IEEE ICDM, 2008. doi:10.1109/ICDM.2008.17
- scikit-learn,
sklearn.model_selection.GroupShuffleSplit. https://scikit-learn.org/stable/modules/generated/sklearn.model_selection.GroupShuffleSplit.html - SEMI, SEMI E30 — Specification for the Generic Model for Communications and Control of Manufacturing Equipment (GEM) (초록). https://store-us.semi.org/products/e03000-semi-e30-specification-for-the-generic-model-for-communications-and-control-of-manufacturing-equipment-gem
- OASIS, MQTT Version 5.0, OASIS Standard, 2019. https://docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html
- Eclipse Mosquitto. https://mosquitto.org/
- PyTorch, “PyTorch 2.6 Release Blog”. https://pytorch.org/blog/pytorch2-6/
- PyTorch,
torch.load. https://docs.pytorch.org/docs/stable/generated/torch.load.html