[팹 IoT 연구 4] 가상 계측(VM) — 25장에 1장만 재면 드리프트를 얼마나 따라가나
먼저 밝혀 둔다. 이 글의 모든 수치는 합성(synthetic) 데이터에서 나왔다. 식각 장비의 센서 요약값과 식각 깊이 사이의 관계, 장비 드리프트, PM(예방정비) 주기, 계측 잡음을 내가 직접 정한 식으로 만들었다. 식의 모양은 물리적 직관(RF 파워가 크면 식각률이 오른다, 챔버 벽이 오염되면 식각률이 떨어진다 등)을 따랐지만 어떤 실제 장비에도 맞춘 것이 아니다. 따라서 아래 숫자는 방법이 어떻게 행동하는지를 보여 줄 뿐, 실제 팹에서 VM이 몇 nm 정확도를 낸다는 주장이 아니다.
연구 질문
가상 계측(Virtual Metrology, VM)은 계측 장비로 모든 웨이퍼를 재지 않고, 공정 장비가 이미 내놓는 센서 데이터로 계측값을 추정하는 기법이다. 이번 실험은 세 가지를 묻는다.
- (a) 단순한 모델(선형/릿지, PLS, kNN, 작은 트리 앙상블)이 “평균값을 찍는” 순진한 기준선보다 얼마나 나은가.
- (b) 장비가 PM 주기를 따라 드리프트할 때 정확도가 얼마나 빨리 떨어지고, 일부 웨이퍼(예: 25장에 1장)만 실측해서 주기적으로 보정하면 얼마나 회복되는가. 이것이 VM의 핵심 트레이드오프, 즉 계측 비용 대 추정 정확도다.
- (c) 예측값 하나만 내지 말고 불확실성(예측 구간)을 함께 낼 때, 드리프트 아래에서도 그 구간을 믿을 수 있는가.
배경 — 반도체 팹에서 이 문제
식각·증착 같은 공정 뒤의 막 두께나 식각 깊이는 별도 계측 장비로 잰다. 모든 웨이퍼를 재면 시간과 장비가 들기 때문에 보통은 일부만 샘플링한다. 그러면 재지 않은 웨이퍼에서 공정이 틀어져도 다음 샘플이 나올 때까지 모른다. VM은 이 공백을 공정 장비 센서(압력, RF 파워, 온도, 가스 유량, 스텝 시간 등)의 웨이퍼별 요약값으로 메운다.
VM 문헌에서는 PLS(Wold et al., 2001)나 정규화 선형 모델(Susto et al., 2015) 같은 단순한 모델이 자주 쓰이고, 장비 상태가 PM과 마모로 변하므로 실측값으로 모델을 계속 갱신하는 구조가 함께 다뤄진다. Cheng 등의 dual-phase VM 체계(IEEE TSM, 2007, doi:10.1109/TSM.2007.907633), 식각 공정에서 국소가중 PLS로 적응형 VM을 설계한 Hirai & Kano(IEEE TSM, 2015, doi:10.1109/TSM.2015.2409299), VM을 run-to-run 제어와 결합한 Kang et al., 2011이 그 예다. run-to-run 제어에서 흔히 쓰는 EWMA 보정은 Sachs·Hu·Ingolfsson(IEEE TSM, 1995, doi:10.1109/66.350755)까지 거슬러 올라간다.
이 글은 그중 가장 단순한 조합, “릿지 회귀 + 샘플 실측값으로 EWMA 바이어스 보정” 이 합성 드리프트 아래에서 어떻게 움직이는지 숫자로 확인한다.
실험 설계
합성 데이터
장비 하나, 챔버 하나를 가정한다. 시드마다 PM 주기 6개를 만들고, 주기마다 350~450장(균등 난수)을 처리한다. 시드당 약 2,400장이다. 웨이퍼마다 레시피 3스텝(안정화 / 메인 식각 / 오버 식각)의 센서 요약 17개를 만든다.
| 스텝 | 피처 |
|---|---|
| 1 안정화 | 압력 평균·표준편차, 유량 평균, ESC 온도 평균, 스텝 시간 |
| 2 메인 식각 | 압력 평균·표준편차, RF 순방향 평균·표준편차, RF 반사 평균, 온도 평균, 유량 평균, 스텝 시간 |
| 3 오버 식각 | 압력 평균, RF 순방향 평균, RF 반사 평균, 스텝 시간 |
숨은 정답(ground truth)은 다음과 같다. 핵심만 발췌한다.
h = offset + slope * i / 400.0        # 숨은 챔버 상태: PM 뒤 i번째 웨이퍼
# slope ~ U(0.04, 0.08)  : 한 주기 동안 식각률이 4~8% 떨어짐
# offset ~ N(0, 0.025)   : PM마다 챔버 상태가 조금씩 다르게 복귀
rate2 = (r0 * (RF2/500)**0.7 * (1 + 0.012*dp - 0.0015*dp**2)
         * np.exp(0.01*(T-40)) * (F/100)**0.3 * (1 - h))
rate3 = 0.4 * r0 * (RF3/200)**0.7 * (1 - h)
depth = rate2 * t2 + rate3 * t3            # nm, 평균 약 128
# 드리프트의 '부분' 관측: 반사파워와 압력 흔들림에만 약하게 드러남
refl2 = 5 + refl_base + 20*h + N(0, 1.5)   # refl_base: PM마다 바뀌는 센서 기준선
y_meas = depth + N(0, 0.8)                 # 계측 잡음 0.8 nm (1σ)
의도는 이렇다. 웨이퍼 간 변동은 대부분 센서로 설명되지만, 드리프트 h는 센서에 일부만 보이고 PM마다 센서 기준선까지 바뀐다. 계측 잡음 때문에 RMSE 0.8 nm 아래로는 원리상 못 내려간다.
(a) 모델 비교
scikit-learn 1.9.1로 7개를 비교했다. 평균 기준선(DummyRegressor), OLS, 릿지(RidgeCV, α를 10⁻³~10³에서 선택), PLS(PLSRegression, 성분 수 1~8을 내부 3-fold로 선택), kNN(k=10), 랜덤포레스트(100그루), 그래디언트 부스팅(GradientBoostingRegressor, 200그루, 깊이 3)이다. 분할은 두 가지다.
- 무작위 5-fold: 전체 웨이퍼를 섞어 나눈다. 시간 순서를 무시하므로 낙관적인 “내삽” 조건이다.
- 시간 분할: 첫 PM 주기로 학습하고 나머지 5주기를 갱신 없이 예측한다. 실제 배치에 가까운 조건이다.
(b) 드리프트와 샘플링 보정
첫 PM 주기(약 400장, 전수 계측 가정)로 릿지를 학습하고, 나머지 약 2,000장을 순서대로 흘린다. k장마다 1장(k = 5, 10, 25, 50, 100)을 실측한다고 보고, 예측은 항상 실측값을 보기 전에 낸다. 비교한 전략은 다섯 가지다.
| 전략 | 설명 |
|---|---|
| static | 학습 뒤 갱신 없음 |
| No VM | 모델 없이 샘플 실측값의 EWMA를 모든 웨이퍼의 추정치로 사용 (PM 직후 첫 장은 실측) |
| EWMA bias | 릿지 예측 + 바이어스. 샘플마다 bias += λ·(y − ŷ), λ = 0.3 |
| EWMA bias + PM reset | 위와 같되, PM 직후 첫 웨이퍼를 반드시 실측하고 그 잔차로 바이어스를 통째로 재설정 |
| window refit | 가장 최근 실측 약 400장(처음엔 학습 주기 데이터)으로 샘플마다 릿지를 다시 학습 |
갱신 루프의 핵심은 이렇다.
pred = model.predict(x) + bias                 # 실측 전에 먼저 예측
if sampled:                                    # k장마다, PM-aware면 PM 직후 첫 장도
    e = y_meas - pred
    bias = bias + e if pm_first else bias + lam * e
(c) 불확실성
목표 포함률 90% 구간을 세 가지로 만들었다. 모두 잔차 절댓값의 분위수를 반폭으로 쓰는 분할 컨포멀 방식이다(Angelopoulos & Bates).
- static conformal: 학습 주기의 5-fold 교차검증 잔차로 한 번 정한 반폭.
- rolling conformal: 가장 최근 실측 20장의 예측 잔차로 반폭을 다시 계산.
- ACI: Gibbs & Candès(2021)의 적응형 컨포멀 추론. 실측이 들어올 때마다 구간 밖이었는지를 보고 유효 α를 γ = 0.05로 조정한다.
포함률은 시뮬레이션이라 모든 웨이퍼의 실측값을 알 수 있으므로 전 웨이퍼 기준으로 셌다. 실제 팹에서는 샘플 웨이퍼로만 셀 수 있다.
모든 실험은 시드 0~9의 10개로 반복했고, 표의 값은 평균 ± 표준편차다. 실행 환경은 2코어 노트북 노드이고 MemoryMax=1500M, CPUQuota=100% 상한 안에서 시드당 80~110초가 걸렸다.
결과
(a) 모델 비교 — RMSE(nm, 실측값 기준)와 R²
| 모델 | 무작위 5-fold RMSE | R² | 첫 주기 → 이후 RMSE | R² |
|---|---|---|---|---|
| 평균 기준선 | 5.77 ± 0.67 | 0.00 ± 0.00 | 7.11 ± 1.84 | −0.78 ± 1.40 |
| OLS | 3.14 ± 0.34 | 0.70 ± 0.04 | 4.82 ± 1.77 | 0.10 ± 1.02 |
| 릿지 | 3.14 ± 0.34 | 0.70 ± 0.04 | 4.83 ± 1.77 | 0.09 ± 1.02 |
| PLS | 3.14 ± 0.35 | 0.70 ± 0.04 | 4.80 ± 1.78 | 0.10 ± 1.02 |
| kNN (k=10) | 3.99 ± 0.36 | 0.52 ± 0.05 | 6.00 ± 2.07 | −0.38 ± 1.49 |
| 랜덤포레스트 | 3.42 ± 0.35 | 0.65 ± 0.04 | 5.56 ± 1.96 | −0.17 ± 1.23 |
| 그래디언트 부스팅 | 3.21 ± 0.36 | 0.69 ± 0.04 | 5.19 ± 1.84 | −0.02 ± 1.09 |
| (참고) 정답값 그대로 | 0.80 ± 0.01 | 0.98 ± 0.00 | 0.80 ± 0.01 | 0.98 ± 0.01 |
(b) 샘플링 간격별 RMSE (nm, 실측값 기준)
| 전략 | 1/5 | 1/10 | 1/25 | 1/50 | 1/100 |
|---|---|---|---|---|---|
| No VM (실측 EWMA) | 4.24 ± 0.09 | 4.31 ± 0.11 | 4.59 ± 0.09 | 5.09 ± 0.23 | 5.85 ± 0.38 |
| EWMA bias | 1.91 ± 0.25 | 2.12 ± 0.29 | 2.56 ± 0.28 | 3.01 ± 0.28 | 3.45 ± 0.49 |
| EWMA bias + PM reset | 1.66 ± 0.27 | 1.71 ± 0.26 | 2.00 ± 0.20 | 2.48 ± 0.18 | 3.15 ± 0.33 |
| window refit | 3.70 ± 0.55 | 3.97 ± 0.72 | 4.30 ± 1.03 | 4.50 ± 1.30 | 4.63 ± 1.45 |
갱신 없는 static 모델은 간격과 무관하게 4.83 ± 1.77이다. 배치 구간 약 2,036장 중 실측 수는 1/25에서 81장(PM reset 전략은 PM 직후 강제 실측 5장이 더해져 86장), 1/5에서 407~411장이다. 1/25 조건의 R²는 static 0.09 ± 1.02, EWMA bias 0.79 ± 0.04, EWMA bias + PM reset 0.87 ± 0.04였다. 정답값 대비 RMSE(계측 잡음 제거)로 보면 PM reset 전략이 1/5에서 1.44, 1/25에서 1.83 nm였다.
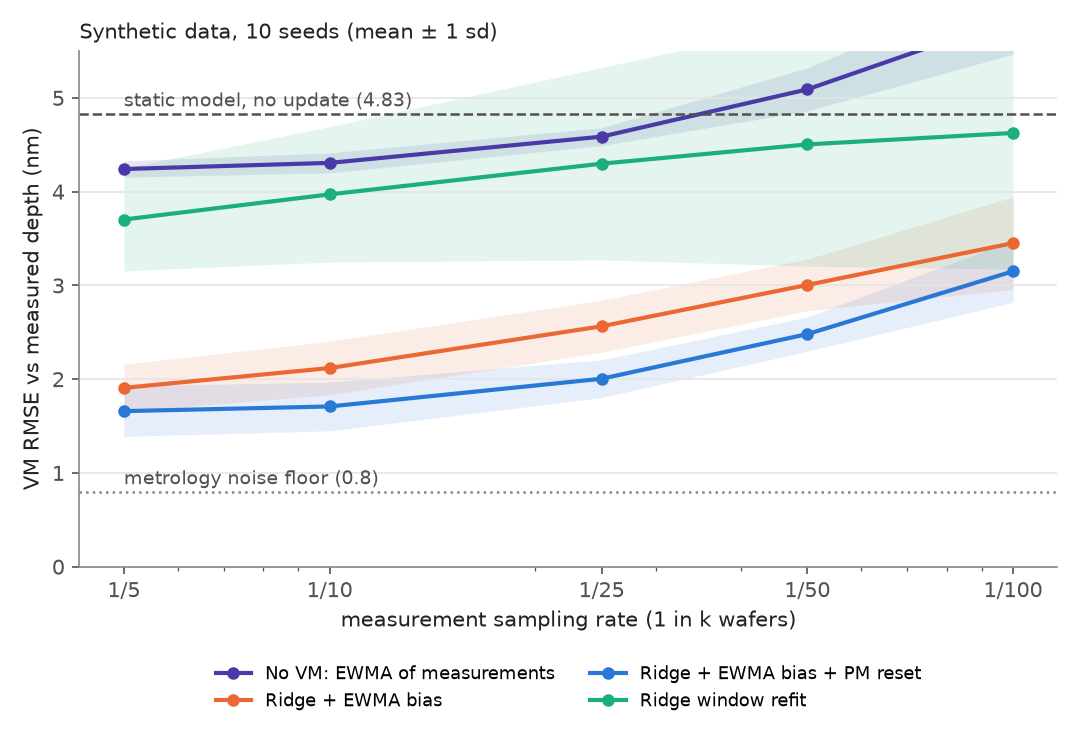
그림 1. 합성 데이터 10시드 평균 ± 1σ. 가로축은 실측 비율, 점선은 계측 잡음 하한(0.8 nm), 파선은 갱신 없는 static 모델.
EWMA 계수 λ에 대한 민감도(PM reset 전략, 1/25):
| λ | 0.1 | 0.3 | 0.6 | 1.0 |
|---|---|---|---|---|
| RMSE (nm) | 2.92 ± 0.24 | 2.00 ± 0.20 | 1.89 ± 0.28 | 2.14 ± 0.35 |
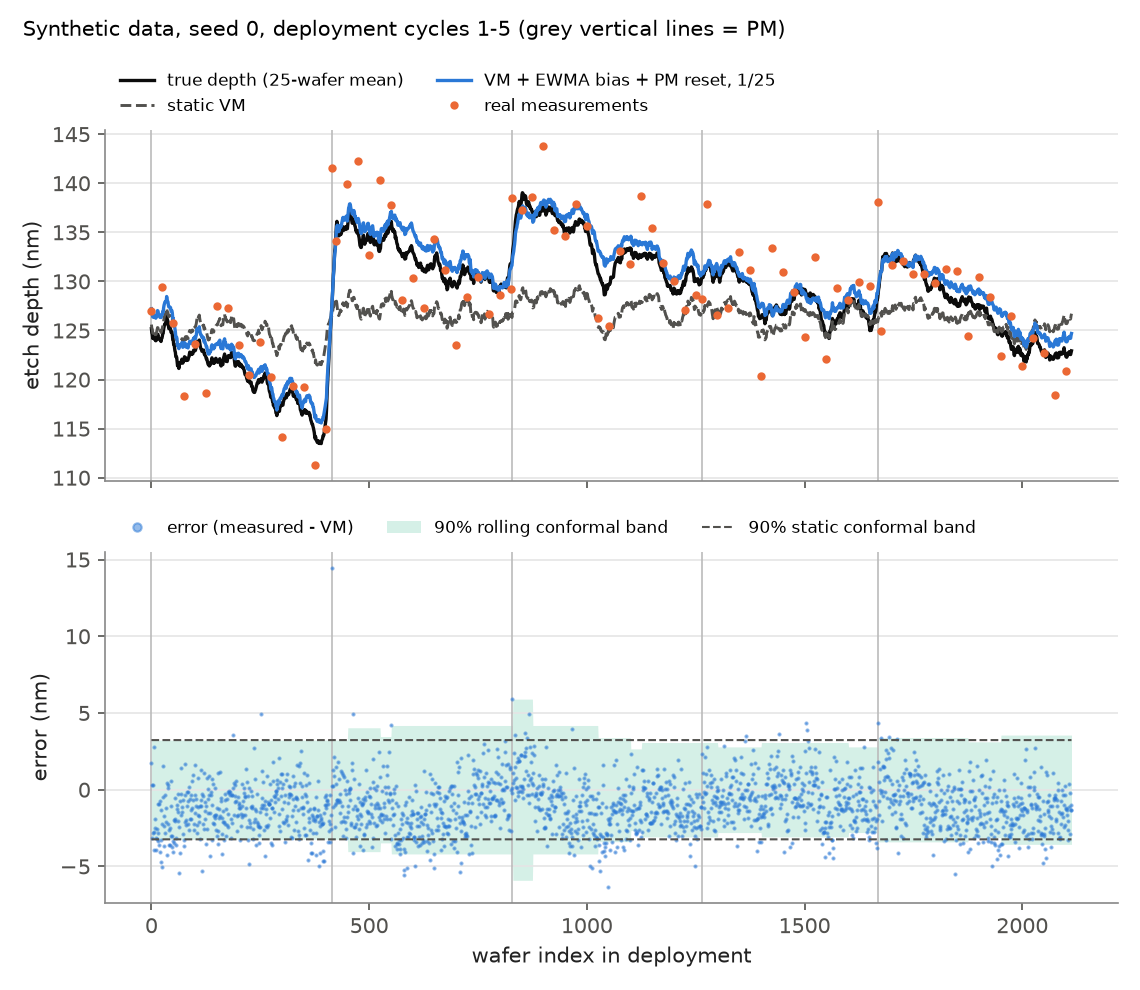
그림 2. 합성 데이터 시드 0, 1/25 실측 + PM reset. 위: 25장 이동평균 비교. 아래: 웨이퍼별 오차와 90% 구간 반폭.
(c) 90% 예측 구간
| 모델 갱신 | 실측 | 구간 | 포함률 | 최악 PM 주기 포함률 | 평균 폭 (nm) |
|---|---|---|---|---|---|
| static | 없음 | static conformal | 0.542 ± 0.233 | 0.250 ± 0.236 | 7.47 ± 0.82 |
| bias + PM reset | 1/25 | static conformal | 0.942 ± 0.024 | 0.902 ± 0.044 | 7.47 ± 0.82 |
| bias + PM reset | 1/25 | rolling (m=20) | 0.945 ± 0.020 | 0.879 ± 0.051 | 8.11 ± 1.01 |
| bias + PM reset | 1/25 | ACI (γ=0.05) | 0.942 ± 0.019 | 0.872 ± 0.057 | 8.71 ± 1.61 |
| bias + PM reset | 1/5 | static conformal | 0.974 ± 0.016 | 0.965 ± 0.023 | 7.47 ± 0.82 |
| bias + PM reset | 1/5 | rolling (m=20) | 0.909 ± 0.010 | 0.886 ± 0.015 | 5.88 ± 0.89 |
| bias + PM reset | 1/5 | ACI (γ=0.05) | 0.904 ± 0.013 | 0.864 ± 0.028 | 6.05 ± 0.84 |
해석
(a) 단순 모델로 충분했다 — 이 데이터에서는. 무작위 분할에서 OLS·릿지·PLS가 RMSE 3.14 nm로 사실상 같았고, 평균 기준선(5.77)보다 확실히 나았다. 트리 계열과 kNN은 오히려 뒤졌다. 정답 함수가 매끈하고 거의 선형(거듭제곱 지수 0.7, 약한 이차항)이라 선형 모델이 유리한 구조였으므로, 이 결과를 “실제 VM에서도 선형이 이긴다”로 읽으면 안 된다. 다만 R²가 0.70에서 멈춘 이유는 의미가 있다. 남은 오차의 상당 부분이 센서에 드러나지 않는 PM별 오프셋에서 오기 때문에, 모델을 바꿔도 이 벽은 넘지 못한다.
시간 분할에서는 모든 모델이 무너졌다. 릿지 RMSE가 3.14에서 4.83으로 올랐고 시드 간 R² 표준편차가 1을 넘었다. 무작위 교차검증 점수는 배치 성능을 크게 과대평가한다.
(b) 정확도를 되찾는 건 모델 재학습이 아니라 바이어스 보정이었다. 25장에 1장(전체의 약 4%)만 재고 바이어스를 EWMA로 따라가면 RMSE가 4.83에서 2.56으로, PM 직후 첫 장을 반드시 재고 바이어스를 재설정하면 2.00으로 내려갔다. 실측 5장을 더 쓰는 대가로 RMSE가 0.5 nm 넘게 줄어든 셈이다. 그림 2에서 이유가 보인다. PM이 일어나면 식각 깊이가 계단처럼 뛰는데(이 시드에서는 약 400번째 웨이퍼), 일반 EWMA는 다음 샘플들을 기다리며 천천히 따라가고, PM-aware 전략은 첫 장에서 바로 맞춘다. 장비가 PM 사실을 이벤트로 알려 준다면 그것을 샘플링 정책에 쓰는 것이 가장 싼 개선이다.
샘플링을 성기게 할수록 RMSE는 단조롭게 나빠졌다. 1/5와 1/10의 차이(1.66 → 1.71)는 작고 1/25 이후 기울기가 커진다. 이 “무릎”의 위치는 드리프트 속도(여기서는 주기당 4~8%)와 계측 잡음이 정하므로 실제 장비에서는 그 장비의 드리프트로 다시 정해야 한다.
모델 없이 실측값의 EWMA만 쓰는 방식은 1/5에서도 4.24 nm에 그쳤다. 웨이퍼 간 변동은 센서 없이 볼 수 없기 때문이다. 웨이퍼 간 변동은 센서 모델이, 드리프트 추적은 샘플 실측이 맡는다는 역할 분담이 숫자로 드러난다. 창 재학습은 1/25에서 4.30으로 훨씬 나빴다. 창의 대부분이 오래된 데이터라 반영이 느리고, 드리프트의 핵심이 센서에 안 보이는 오프셋이라 계수를 다시 맞춰도 수준 이동은 못 잡는다.
λ는 0.3~0.6이 비슷했고 0.1은 너무 느렸으며 1.0(마지막 잔차를 그대로 믿기)은 계측 잡음을 그대로 끌고 들어와 다시 나빠졌다. 그림 2 아래 패널에서 오차가 0보다 약간 아래로 치우친 것은 바이어스가 주기 내 하강 추세를 한 박자 늦게 따라가기 때문이다. 기울기까지 추정하는 이중 EWMA류 보정이 이 지연을 줄일 수 있겠지만 이번에는 시험하지 않았다.
(c) 구간은 모델 갱신과 짝을 지어야 의미가 있다. 갱신 없는 모델에 학습 때 정한 90% 구간을 붙이면 실제 포함률은 54%, 최악의 PM 주기에서는 25%였다. “±3.7 nm”라고 말하면서 절반 가까이가 그 밖에 있는 셈이다. 바이어스 보정을 붙이면 같은 정적 구간이 94~97%로 오히려 과대 포함됐다. 학습 주기 잔차에 주기 내 드리프트가 섞여 넉넉하게 잡혔기 때문이다.
적응형 구간은 실측이 촘촘할 때 제 역할을 했다. 1/5에서 rolling conformal과 ACI는 포함률 0.90~0.91로 목표에 붙었고 폭은 7.47에서 5.9~6.1 nm로 좁아졌다. 1/25에서는 둘 다 94% 이상으로 넉넉해지고 폭은 오히려 넓어졌다. 최근 20장을 모으는 데 500장이 걸리고 그 안에 PM 직후의 큰 잔차(그림 2의 14 nm 튀는 점)가 섞이기 때문이다. 적응형 구간의 최악 주기 포함률(0.86~0.89)은 목표보다 낮았다. 구간을 정직하게 유지하는 비용도 실측 샘플에서 나온다.
IoT 파이프라인과 연결
장비 옆 엣지 노드가 센서 원시 트레이스를 받아 웨이퍼가 끝날 때 스텝별 요약 17개만 계산해 MQTT 메시지 하나로 보내면, 브로커에는 웨이퍼당 수백 바이트만 흐른다.
토픽: fab/etch01/chA/wafer/summary   QoS 1
{"wafer_id":"W0423","lot":"L017","since_pm":23,
 "s2_RF_mean":501.3,"s2_refl_mean":6.1, ... ,"s3_time":15.2}

토픽: fab/etch01/chA/event/pm         QoS 1, retained   (PM 완료 이벤트)
토픽: fab/metrology/result           QoS 1             (샘플 웨이퍼 실측값)
VM 서비스는 summary로 예측과 구간을 내고, metrology/result로 바이어스와 잔차 버퍼를 갱신하며, event/pm이 오면 다음 웨이퍼를 실측 대상으로 표시한다. 실측값은 늦게 도착하므로 wafer_id로 짝을 맞추고, QoS 1은 같은 메시지가 두 번 올 수 있으므로 wafer_id 기준으로 멱등 처리해야 바이어스가 두 번 갱신되지 않는다. MQTT 5.0의 QoS 의미와 retained 메시지 동작은 OASIS MQTT 5.0 명세에 정의돼 있다. 이 부분은 설계 스케치이고 이번 실험에서 브로커를 실제로 띄워 돌리지는 않았다.
한계
- 합성 데이터다. 정답 함수, 드리프트 형태(주기 내 선형 + PM 오프셋), 센서 노이즈 크기를 모두 내가 정했다. 실제 식각 공정의 비선형성, 다중 챔버, 레시피 변경, 소모품 수명, 센서 고장, 계측 지연은 들어 있지 않다. 결론의 방향(무작위 CV의 낙관성, 바이어스 보정의 효과, PM-aware 샘플링의 이득, 구간 포함률 붕괴)은 이 설정에서 확인된 것이고, 크기는 설정에 따라 얼마든지 바뀐다.
- 선형 모델이 이긴 것은 정답 함수가 거의 선형이기 때문일 가능성이 크다. 트리 앙상블을 깎아내리는 근거가 아니다.
- 드리프트가 센서에 얼마나 드러나는지(
20*h계수, 기준선 이동)가 결과를 크게 좌우한다. 이 값을 바꾼 민감도 분석은 하지 않았다. - 샘플링은 고정 간격만 봤다. 예측 불확실성이 큰 웨이퍼를 골라 재는 적응형 샘플링은 다루지 않았다.
- 실측은 즉시 도착한다고 가정했다. 실제로는 계측 대기열 때문에 수십 장 늦게 올 수 있고, 그만큼 보정이 늦어진다.
- 구간 포함률은 시뮬레이션이라 전 웨이퍼로 셌다. 실제로는 샘플 웨이퍼로만 추정할 수 있다. 시드 10개는 꼬리 행동을 말하기에 적다.
재현 방법
python3 -m venv venv
venv/bin/pip install numpy scikit-learn matplotlib pandas
# 실험 당시 버전: scikit-learn 1.9.1, numpy 2.5.4, pandas 3.0.6, matplotlib 3.11.2
./run_all.sh          # 시드 0~9를 각각 별도 프로세스로 실행한 뒤 aggregate.py 호출
구성 파일은 vmsim.py(합성 데이터 생성기, 정답 식 포함), run_experiments.py(질문 a·b·c), aggregate.py(표·그림)다. 결과는 results/에 시드별 원자료(data_seed*.csv, 웨이퍼별 피처·정답·실측·숨은 상태 h), 실험별 CSV, 요약 SUMMARY.md로 남는다. 시드가 고정돼 있어 같은 라이브러리 버전이면 같은 숫자가 나와야 한다. 각 시드는 systemd-run --user --scope -p MemoryMax=1500M -p CPUQuota=100% 안에서 실행했다.
References
- Wold, S., Sjöström, M., & Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2). doi:10.1016/S0169-7439(01)00155-1
- Susto, G. A., Pampuri, S., Schirru, A., Beghi, A., & De Nicolao, G. (2015). Multi-step virtual metrology for semiconductor manufacturing: A multilevel and regularization methods-based approach. Computers & Operations Research. doi:10.1016/j.cor.2014.05.008
- Kang, P., Kim, D., Lee, H., Doh, S., & Cho, S. (2011). Virtual metrology for run-to-run control in semiconductor manufacturing. Expert Systems with Applications. doi:10.1016/j.eswa.2010.08.040
- Cheng, F.-T., Huang, H.-C., & Kao, C.-A. (2007). Dual-Phase Virtual Metrology Scheme. IEEE Transactions on Semiconductor Manufacturing. doi:10.1109/TSM.2007.907633
- Hirai, T., & Kano, M. (2015). Adaptive Virtual Metrology Design for Semiconductor Dry Etching Process Through Locally Weighted Partial Least Squares. IEEE Transactions on Semiconductor Manufacturing. doi:10.1109/TSM.2015.2409299
- Sachs, E., Hu, A., & Ingolfsson, A. (1995). Run by run process control: combining SPC and feedback control. IEEE Transactions on Semiconductor Manufacturing. doi:10.1109/66.350755
- Gibbs, I., & Candès, E. (2021). Adaptive Conformal Inference Under Distribution Shift. arXiv:2106.00170
- Angelopoulos, A. N., & Bates, S. A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification. arXiv:2107.07511
- scikit-learn 문서: PLSRegression, RidgeCV, GradientBoostingRegressor
- OASIS. MQTT Version 5.0, OASIS Standard. docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html