[팹 IoT 연구 3] SECS/GEM → MQTT 게이트웨이 시제품과 브로커 재시작 실험
이 글의 장비는 가상의 식각 장비 시뮬레이터이고, 모든 값(챔버 온도, 웨이퍼 ID, 알람)은 시드를 고정한 합성 데이터다. 실제 장비나 팹 데이터는 하나도 쓰지 않았다. 브로커·게이트웨이·장비·구독자 네 프로세스를 노트북 한 대의 127.0.0.1 위에서 돌렸고, 수치는 그 환경에서 실제로 측정한 값이다.
SEMI 표준 본문(E5, E30, E37)은 유료 문서라 읽지 않았다. 표준에 관한 서술은 SEMI 스토어에 공개된 초록과, 오픈소스 구현체인 secsgem 공식 문서·소스 코드에서 확인할 수 있는 범위로 한정했다. 표준 조항 번호나 타이머 기본값처럼 본문을 봐야 알 수 있는 내용은 쓰지 않는다.
연구 질문
- HSMS 세션(Select, Linktest)을 유지하면서 S6F11 이벤트 리포트, S5F1 알람, S1F3/S1F4 상태 변수를 받아 MQTT JSON으로 다시 내보내는 게이트웨이를 순수 파이썬으로 만들면, 코어 1개 분량의 CPU에서 초당 몇 건까지, 지연은 p50/p95 몇 ms로 나르는가?
- 그 병목은 HSMS 쪽인가 MQTT 쪽인가?
- MQTT 브로커가 죽었다 살아나면 무엇이 사라지는가? QoS 0, QoS 1 + 클라이언트 큐, QoS 1 + 게이트웨이 스풀은 각각 어떻게 다른가?
- 토픽 계층과 페이로드 스키마, 보안 경계는 어떻게 잡는 게 합리적인가?
배경 — 반도체 팹에서 이 문제
반도체 장비와 공장 호스트(MES 등) 사이의 표준 통신은 세 층으로 나뉜다. SEMI 스토어의 공개 초록 기준으로 정리하면 이렇다.
- SEMI E5 (SECS-II): “intelligent equipment와 host 사이에 교환되는 메시지의 해석 세부”를 정의한다. 메시지는 Stream(활동 범주)과 Function(개별 메시지)으로 분류되고, 데이터는 아이템과 리스트로 된 자기 기술 형식이다(SEMI E5 초록).
- SEMI E37 (HSMS): SECS-II 메시지를 TCP/IP 위에서 주고받는 방식이다. 초록은 HSMS가 서로를 몰라도 접속해 상호 운용되는 구현을 가능하게 하고, 더 빠른 통신이 필요한 곳에서 SEMI E4(SECS-I, 직렬)를 대체하는 용도라고 설명한다(SEMI E37 초록).
- SEMI E30 (GEM): 모든 장비에 공통인 SECS-II 사용법이다. 초록에 수집 이벤트(collection event), 알람, 원격 명령, 데이터 변수·상태 변수·장비 상수 같은 범위가 명시돼 있다(SEMI E30 초록).
HSMS 메시지 구조는 secsgem 문서에서 확인했다. 메시지마다 헤더가 있고, 헤더의 system id로 요청과 응답을 짝지으며, 제어 메시지는 s_type으로 구분한다(Select 1/2, Deselect 3/4, Linktest 5/6, Reject 7, Separate 9, 데이터 메시지 0). 문서에 실린 인코딩 예시는 4바이트 길이 필드와 10바이트 헤더로 되어 있다(secsgem HSMS messages).
팹 IoT에서 이 게이트웨이가 필요한 이유는 단순하다. 장비 데이터는 HSMS라는 1:1, 요청-응답, 장비망 전용 프로토콜로 나오는데, 분석·대시보드·이상 탐지 쪽은 1:N 발행-구독을 원한다. 장비 하나에 HSMS 호스트를 여럿 붙일 수는 없으니(이 실험의 구성도 단일 세션이다), 누군가 한 번 받아서 퍼뜨려야 한다. 동시에 장비망을 사무망(IT)에 노출하면 안 된다. 게이트웨이는 이 두 요구가 만나는 지점이다.
실험 설계
구성
[equipment.py]  --HSMS/TCP 127.0.0.1:15000-->  [gateway.py]  --MQTT 127.0.0.1:18883-->  [broker.py (amqtt)]  -->  [subscriber.py]
 secsgem GemEquipmentHandler (passive)          secsgem GemHostHandler (active)            pure-Python broker          지연 측정
                                                + paho-mqtt 2.1.0
| 구성 요소 | 구현 | 비고 |
|---|---|---|
| 장비 시뮬레이터 | secsgem 0.3.0 GemEquipmentHandler |
SV 1101~1103(온도·압력·RF), CE 3001 WaferProcessed, 알람 4001 |
| 게이트웨이 | GemHostHandler + paho-mqtt 2.1.0 |
S2F33/35/37로 리포트 정의·연결·활성, S5F3으로 알람 활성 |
| 브로커 | amqtt 0.12.1 | 127.0.0.1에만 바인드, 영속화 플러그인 없음 |
| 구독자 | paho-mqtt | fab/v1/# 구독, 수신 시각 기록 |
secsgem은 HSMS 연결 모드(active/passive), Select, Linktest 응답을 라이브러리가 처리한다(secsgem HSMS protocol). 게이트웨이 쪽에서 주기 Linktest 간격을 5초로 줄여 실행 중에 실제로 Linktest가 오가는지 셌다. 실험 도중 secsgem 0.3.0이 SVID 1001~1005를 내장 변수(Clock, ControlState 등)로 쓴다는 것을 알게 돼 장비 SV를 1101번대로 옮겼다. 처음엔 ID가 겹쳐서 S1F3 응답이 예외로 끝났다.
데이터 흐름과 시각 측정
장비는 S6F11을 보낼 때 DV EVT_TS_NS에 자기 시각(ns)을 넣는다. 게이트웨이는 받는 순간 t_gw_ns를 붙여 발행하고, 구독자는 수신 시각 t_rx_ns를 기록한다. 네 프로세스가 같은 호스트의 같은 시계를 쓰므로 시계 동기 오차가 없다. 지연은 세 가지로 나눴다.
- HSMS 구간 =
t_gw - t_eq(SECS-II 인코딩, TCP, 디코딩, 게이트웨이 콜백까지) - MQTT 구간 =
t_rx - t_gw(JSON 직렬화, 브로커 경유, 구독자 수신까지) - 종단 간 =
t_rx - t_eq
부하 수준
목표 발생률 10, 50, 100, 200건/s, 그리고 제한 없음(max)을 각 15초씩 3회 반복했다. 장비는 기본적으로 S6F11을 보내고 S6F12 응답을 받은 뒤 다음을 보낸다(열린 트랜잭션 W=1). 비교용으로 W=4(동시에 4건 대기)와 QoS 0을 추가했다. 부하와 별개로 장비는 2초마다 알람을 설정/해제(S5F1 + CE 3101/3102)하고, 게이트웨이는 1초마다 S1F3으로 SV를 폴링한다.
모든 실행은 systemd-run --user --scope -p MemoryMax=1500M -p CPUQuota=100% nice -n 10 안에서 돌렸다. CPU 한도 100%는 네 프로세스가 함께 나눠 쓰는 값이다. 같은 노드에서 다른 실험 3개가 동시에 돌았고, 실행 시작 시 1분 load average는 4.6~7.8이었다.
브로커 재시작
50건/s로 20초를 흘리면서 시작 6초 뒤 브로커를 SIGKILL하고 5초 뒤 다시 띄웠다. 게이트웨이 버퍼 모드는 세 가지다.
none: QoS 0. 끊긴 동안의publish()는MQTT_ERR_NO_CONN으로 버려진다.paho: QoS 1. paho 클라이언트 내부 큐에 맡긴다. paho 문서상max_queued_messages_set(0)은 무제한이다(paho client 문서).spool: QoS 1. 게이트웨이가 직접 상한 있는 deque에 쌓고, 재접속 1초 뒤부터 비운다.
각 모드를 3회 반복했고, 구독자가 늦게 재접속하는 경우(첫 재접속 대기 8초)를 paho, spool에 대해 2회씩 추가했다.
토픽 계층과 페이로드
fab/v1/{site}/{area}/{eqp}/event/{CEID 이름}     S6F11   QoS1
fab/v1/{site}/{area}/{eqp}/alarm/{ALID}          S5F1    QoS1, retain
fab/v1/{site}/{area}/{eqp}/status                S1F4    QoS1, retain
fab/v1/{site}/{area}/{eqp}/gw/state              LWT     QoS1, retain ("online"/"offline")
실제 페이로드 한 건(웨이퍼 이벤트)은 다음과 같다.
{"type":"event","ceid":3001,"name":"WaferProcessed","rptid":100,
 "data":{"EVT_SEQ":123,"EVT_TS_NS":1791732198898812395,"WAFER_ID":"W0000123"},
 "src":"S6F11","t_eq_ns":1791732198898812395,"seq_gw":130,"v":1,"eqp":"EQP01","t_gw_ns":1791732198907811479}
설계 판단은 이렇다. 토픽 맨 앞의 v1은 스키마 버전이고, 페이로드 안에도 v를 둬서 토픽을 바꾸지 않고 필드를 추가할 수 있게 했다. 숫자 CEID 대신 이름을 토픽에 넣어 구독자가 +/event/WaferProcessed처럼 장비 종류를 넘나들어 구독할 수 있게 했고, 숫자 ID는 페이로드에 남겼다. seq_gw는 게이트웨이가 매기는 단조 증가 번호라 구독자가 누락을 감지할 수 있다. 상태와 알람은 retain으로 둬서 새 구독자가 접속 즉시 최신 값을 받는다. LWT(will_set)는 paho 문서 설명대로 비정상 종료 때 브로커가 대신 발행하는 메시지라 게이트웨이 생존 여부를 별도 하트비트 없이 알린다.
같은 이벤트의 HSMS 프레임은 58바이트(SECS-II 본문 44바이트 + 길이·헤더 14바이트)였고, JSON은 248바이트였다(src/sizes.py로 측정). 약 4.3배다. 대역폭이 문제가 되는 규모는 아니지만, 고빈도 트레이스 데이터를 그대로 JSON으로 풀면 이 비율이 그대로 따라온다.
게이트웨이 핵심 부분은 아래와 같다(발췌).
def on_ce(data):                      # secsgem이 S6F11을 디코딩해 넘겨준 리포트
    ceid = data["ceid"].get()
    vals = {DV_NAMES.get(v["dvid"], str(v["dvid"])): v["value"] for v in data["values"]}
    body = {"type": "event", "ceid": ceid, "name": CE_NAMES.get(ceid, str(ceid)),
            "rptid": data["rptid"].get(), "data": vals, "src": "S6F11"}
    if "EVT_TS_NS" in vals:
        body["t_eq_ns"] = vals["EVT_TS_NS"]
    publish(f"event/{CE_NAMES.get(ceid, ceid)}", body)

def publish(sub, body, retain=False):
    global seq_gw
    with seq_lock:
        seq_gw += 1; body["seq_gw"] = seq_gw
    body.update({"v": 1, "eqp": EQP, "t_gw_ns": time.time_ns()})
    topic, payload = f"{BASE}/{sub}", json.dumps(body, separators=(",", ":"))
    if a.mode == "spool" and (not connected.is_set() or spool):
        spool.append((topic, payload, retain)); return
    mq.publish(topic, payload, qos=QOS, retain=retain)
결과
처리량과 지연
3회 반복의 중앙값이다. 괄호는 최솟값~최댓값.
| 조건 | 수신 처리량 (건/s) | 종단 p50 (ms) | 종단 p95 (ms) | HSMS p50 / p95 | MQTT p50 / p95 | 손실 / 중복 |
|---|---|---|---|---|---|---|
| 10/s, W1, QoS1 | 10.0 | 7.6 (6.7~8.2) | 28.5 (24.8~31.2) | 4.6 / 20.7 | 2.5 / 10.2 | 0 / 0 |
| 50/s, W1, QoS1 | 50.0 | 8.0 (6.4~12.6) | 24.9 (20.5~32.0) | 4.7 / 14.8 | 2.9 / 10.6 | 0 / 0 |
| 100/s, W1, QoS1 | 99.7 (99.5~100) | 7.4 (6.6~7.9) | 19.3 (17.5~21.7) | 4.1 / 11.4 | 2.9 / 9.5 | 0 / 0 |
| 200/s, W1, QoS1 | 126.1 (72.1~136.7) | 6.2 (6.0~11.3) | 21.6 (19.2~29.9) | 3.7 / 11.9 | 2.3 / 8.4 | 0 / 0 |
| max, W1, QoS1 | 132.5 (118.7~140.3) | 5.8 (5.5~6.7) | 21.9 (19.4~22.6) | 3.5 / 11.7 | 2.1 / 7.3 | 0 / 0 |
| max, W4, QoS1 | 141.7 (111.2~143.4) | 21.3 (20.2~31.2) | 66.1 (65.5~75.1) | 14.6 / 60.5 | 4.1 / 25.7 | 0 / 0 |
| max, W1, QoS0 | 154.3 (119.8~168.9) | 5.3 (5.0~6.6) | 16.9 (13.0~21.5) | 3.4 / 9.1 | 1.8 / 5.5 | 0 / 0 |
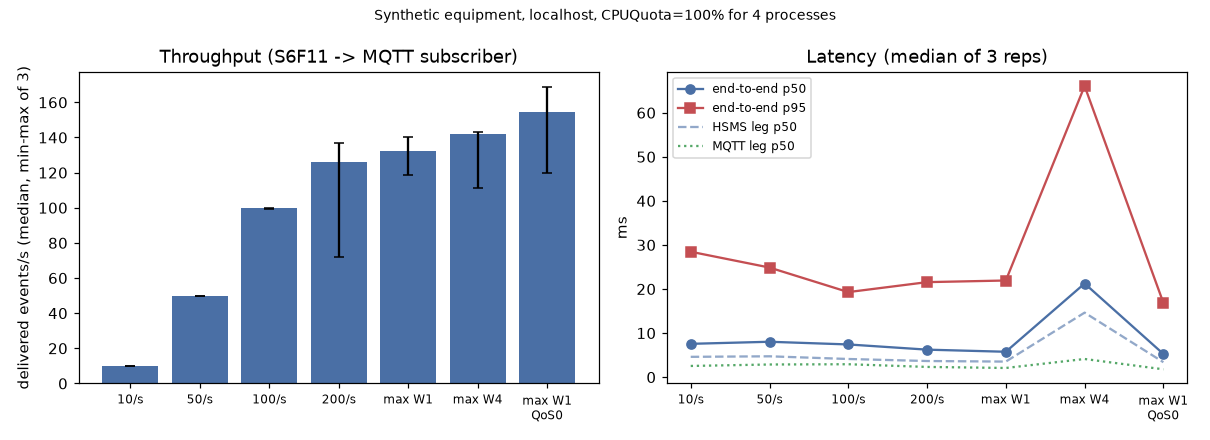
21회 실행 전부에서 Linktest가 실행당 3회 오갔고(5초 간격), S5F1 알람 7건과 S1F3 폴링 16회가 모두 처리됐다. 정상 상태에서는 QoS 0이든 1이든 손실과 중복이 0이었다.
CPU 사용 시간을 프로세스별로 나눠 보면(max, W1, QoS1, 중앙값) 게이트웨이 6.73초, 장비 4.03초, 브로커 2.87초, 구독자 0.92초였다. 합쳐서 수신 메시지 1건당 약 7.3 ms의 CPU를 썼다. 이 값은 Linktest·S1F3 폴링 같은 고정 비용을 포함한 근사치다.
브로커 재시작
50건/s, 20초(약 1,001건), 6초 지점에서 5초 동안 브로커 정지.
| 모드 | 반복 | 장비가 받은 S6F12 | 손실 (정지 전 / 정지 중 / 재기동 후) | 정지 중 발생분의 최대 지연 | 게이트웨이 재접속 (기동 후) |
|---|---|---|---|---|---|
| none (QoS0) | 1 | 1001/1001 | 323 (1 / 252 / 70) | 전량 손실 | 1,423 ms |
| none (QoS0) | 2 | 1001/1001 | 272 (1 / 250 / 21) | 전량 손실 | 433 ms |
| none (QoS0) | 3 | 1001/1001 | 270 (0 / 250 / 20) | 전량 손실 | 410 ms |
| paho (QoS1) | 1~3 | 전부 | 0, 0, 0 | 5.5 s, 6.7 s, 5.5 s | 416, 1,419, 426 ms |
| spool (QoS1) | 1~3 | 전부 | 0, 0, 0 | 7.4 s, 6.4 s, 7.4 s | 1,429, 414, 1,409 ms |
| paho, 구독자 늦게 재접속 | 1~2 | 전부 | 400, 401 (1 / 250 / 149~150) | 전량 손실 | 1,412 ms (구독자 3,001~3,006 ms) |
| spool, 구독자 늦게 재접속 | 1~2 | 전부 | 400, 402 (0~2 / 250 / 150) | 전량 손실 | 428~1,410 ms (구독자 3,000~3,006 ms) |
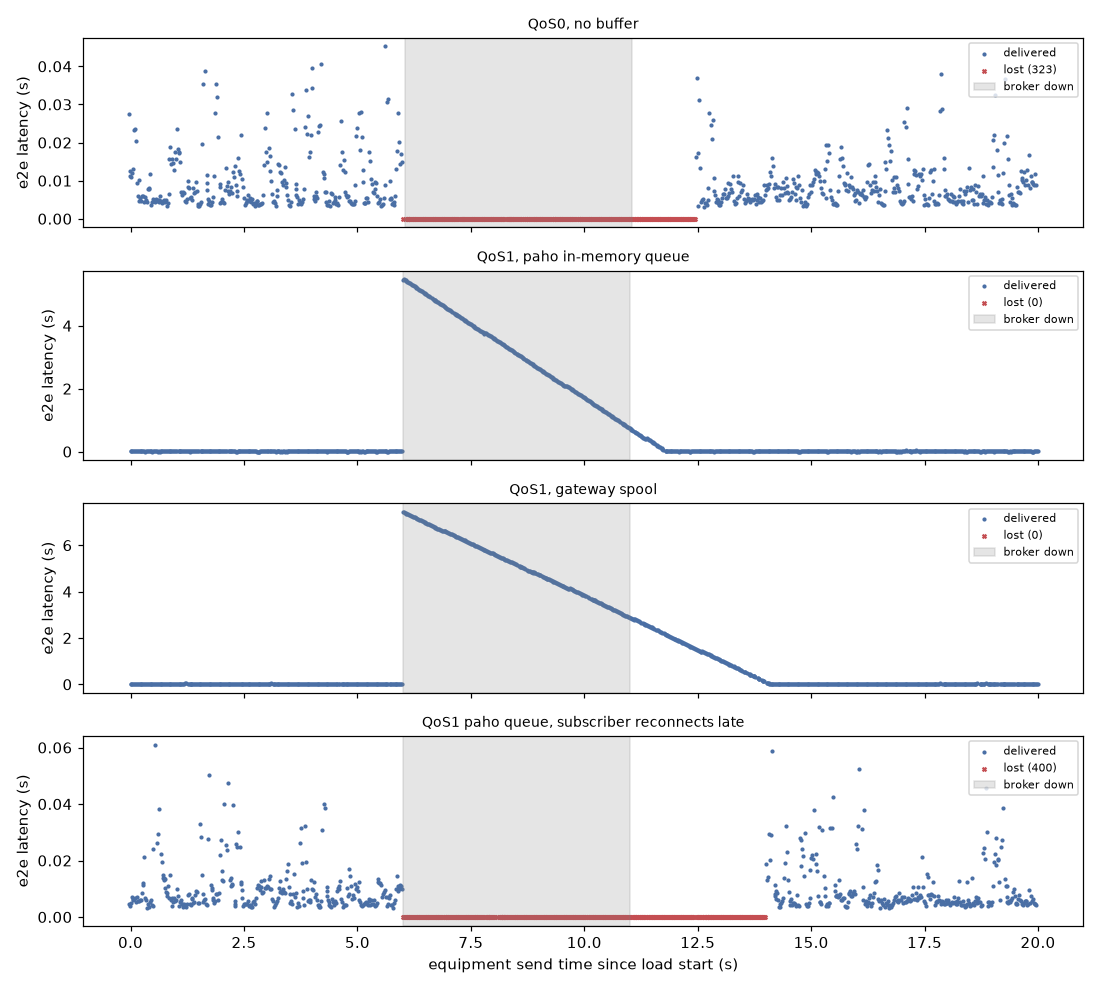
모든 경우에 장비 쪽 HSMS 송신률은 50건/s로 유지됐고, S6F12도 전부 정상으로 돌아왔다. 중복 수신은 한 건도 없었다.
해석
병목은 CPU이고, 가장 비싼 건 게이트웨이다. 메시지당 CPU 7.3 ms에 코어 1개 한도를 대입하면 1000 / 7.3 ≈ 137건/s가 나온다. 측정된 포화 처리량 132~154건/s와 맞는다. 프로토콜 왕복 대기가 병목이었다면 W=4에서 처리량이 크게 늘었어야 하는데, 중앙값은 132.5 → 141.7건/s로 7%만 늘고 HSMS 구간 p95는 11.7 → 60.5 ms로 다섯 배가 됐다. 이미 CPU가 차 있는 상태에서 동시 트랜잭션을 늘리면 줄만 길어진다는 뜻이다. 따라서 이 숫자는 “SECS/GEM→MQTT의 한계”가 아니라 “이 환경에서 순수 파이썬 스택 4개를 코어 하나에 몰아넣은 한계”로 읽어야 한다. 실제 배치에서는 장비와 브로커가 게이트웨이와 CPU를 나눠 쓰지 않으므로, 게이트웨이 몫(이 실험에서 약 46%)만 남는다.
지연은 HSMS 구간이 MQTT 구간보다 길다. p50 기준 HSMS 3.4~4.7 ms, MQTT 1.8~2.9 ms였다. HSMS 쪽에는 secsgem의 SECS-II 디코딩과 GEM 핸들러 디스패치가 들어 있고, MQTT 쪽은 JSON 직렬화와 브로커 한 번 경유다. p95가 p50의 3~4배로 꼬리가 긴데, 같은 노드의 다른 실험과 CPU를 다투는 환경이라 스케줄링 지연이 섞였을 가능성이 크다. 장비 데이터 수집 용도(초 단위 상태, 웨이퍼 단위 이벤트)에는 수십 ms가 문제되지 않지만, 이 경로를 제어 루프에 쓰면 안 된다는 점은 분명하다.
S6F12 응답은 “MQTT로 전달됨”을 뜻하지 않는다. 이번 실험에서 가장 중요한 관찰이다. QoS 0 모드에서 장비는 1,001건 모두 S6F12를 받았지만 구독자에게는 27~32%가 닿지 않았다. 게이트웨이가 HSMS 응답을 MQTT 전달과 무관하게 즉시 보내기 때문이다. 장비 입장에서는 데이터가 넘어갔으므로 다시 보낼 이유가 없다. 그러니 게이트웨이 뒤에서 잃은 데이터는 되돌릴 방법이 없다. 이 구조에서 데이터 보존의 책임은 전적으로 게이트웨이 이후 구간에 있다.
QoS 1과 재전송 큐는 “게이트웨이→브로커” 구간만 지킨다. paho, spool 모드는 구독자가 제때 재접속한 6회 모두 손실이 0이었고, 정지 중 발생분은 5.5~7.4초 늦게 도착했다(그림의 대각선). 스풀은 재접속 후 1초를 기다렸다 비우도록 만들어 최대 지연이 약 1초 더 길다. 그런데 구독자가 3초 늦게 붙자 두 모드 모두 400건(약 8초 분량)을 잃었다. 게이트웨이는 재접속하자마자 쌓아 둔 메시지를 브로커로 보냈고 브로커는 PUBACK까지 줬지만, 그 순간 그 토픽을 구독하는 세션이 브로커에 없었다. amqtt를 영속화 없이 띄웠기 때문에 재기동한 브로커는 구독자의 이전 세션(clean_session=False)을 모른다. 구독자의 session_present가 모든 실행에서 False였던 것이 그 증거다. 정상 경우에 손실이 없었던 이유는 게이트웨이와 구독자가 같은 재접속 백오프를 써서 몇 ms 차이로 붙었기 때문이고, 설계가 보장한 결과가 아니라 타이밍이 맞은 것이다. 일부 실행에서 정지 직전 1~2건이 사라진 것도 같은 맥락으로 본다. 브로커가 받기는 했지만 구독자에게 넘기기 전에 프로세스가 죽은 경우로 추정하며, 이 실험만으로 확정하지는 않았다.
설계로 옮기면 이렇다.
- 브로커에 세션·메시지 영속화가 있어야 QoS 1의 “at least once”가 브로커 재시작을 넘어선다. MQTT 사양은 세션 상태를 서버가 유지하는 모델을 정의하지만(MQTT 3.1.1, MQTT 5.0), 그것을 디스크에 남기는지는 브로커 구현과 설정의 문제다.
- 게이트웨이 버퍼는 메모리 deque가 아니라 디스크 스풀이어야 한다. 이번
paho,spool모드는 게이트웨이 프로세스가 죽으면 쌓인 것을 전부 잃는다. - 구독자는
seq_gw공백을 감지해야 하고, 공백을 메울 경로(게이트웨이 측 일정 기간 보관 + 재요청 API, 또는 브로커가 아닌 로그 저장소)가 필요하다. - retain된 알람 상태도 브로커와 함께 사라진다. 게이트웨이는 재접속할 때 S5F5/S5F7 같은 조회로 현재 알람 목록을 다시 받아 발행하는 편이 안전하다. 상태(S1F4)는 1초 폴링이라 스스로 복구된다.
JSON 숫자 정밀도. t_eq_ns 같은 ns 정수는 2^53을 넘어서 JavaScript의 Number로 읽으면 하위 자릿수가 깎인다. 파이썬 구독자에서는 문제가 없었지만, 웹 대시보드가 붙는다면 ms 정수나 문자열로 보내는 게 맞다. U8 같은 SECS-II 64비트 정수형도 같은 문제가 있다.
보안
- HSMS는 IT망에 노출하지 않는다. 게이트웨이의 HSMS 쪽은 장비망 인터페이스에만 바인드하고, IT망 쪽으로는 MQTT(또는 그보다 바깥의 수집 계층)만 연다. 이번 시제품은 HSMS와 MQTT 둘 다
127.0.0.1에만 바인드했다. HSMS 연결 절차에는 인증 단계가 따로 보이지 않는다(secsgem 문서가 설명하는 것은 Select/Linktest 같은 연결 관리 메시지뿐이다). 그래서 포트에 닿을 수 있는 누구나 호스트 행세를 할 수 있다고 가정하고 망 분리로 막아야 한다. OT 망 분리와 구역(zone) 설계는 NIST SP 800-82r3이 다루는 일반 원칙과 같은 맥락이다. 팹 장비 사이버보안 기준선으로는 SEMI E187이 있다(이 글은 초록만 확인했다). - 게이트웨이는 읽기 방향만 연다. 이번 게이트웨이는 S2F41(원격 명령)을 MQTT에서 받아 장비로 넘기는 경로를 일부러 만들지 않았다. MQTT 토픽 하나로 장비를 움직일 수 있게 되면 IT망 침해가 곧바로 공정 사고로 이어진다.
- MQTT는 TLS와 클라이언트 인증, 토픽 ACL을 쓴다. 이번 실험은 측정 단순화를 위해 익명 접속을 허용했다. 운영에서는 게이트웨이마다 고유 자격증명(가능하면 클라이언트 인증서)을 주고, ACL로 게이트웨이
EQP01은fab/v1/+/+/EQP01/#에만 쓰기, 분석 계정은 읽기만 허용해야 한다. amqtt에도 비밀번호 파일 인증 플러그인이 있지만(amqtt 문서), 이번에는 검증하지 않았다. - LWT와 retain은 보안 신호이기도 하다.
gw/state가 offline으로 바뀌는 것은 장애 알림이면서, 예상하지 못한 게이트웨이 재접속(같은 client id로 다른 곳에서 접속)을 감지하는 단서가 된다.
한계
- 합성 데이터, 가상 장비. 장비는 secsgem으로 만든 시뮬레이터이고, CEID·SVID·ALID 번호와 값은 모두 임의로 정했다. 실제 장비의 GEM 구현, 리포트 크기, 이벤트 빈도, 벤더별 특이 동작은 반영되지 않았다.
- 표준 본문 미확인. E5/E30/E37 본문을 읽지 않았으므로 이 시제품이 GEM 준수라고 주장하지 않는다. 동작은 secsgem 0.3.0이 구현한 범위다. 타이머(T3~T8 등)도 라이브러리 기본값을 따랐고, Linktest 간격만 5초로 바꿨다.
- 같은 노드, 공유 CPU. 네 프로세스가 코어 하나 분량을 나눠 썼고 다른 실험 3개와 동시에 돌았다. 200/s 반복 중 한 번은 72건/s까지 떨어졌다. 같은 부하를 처음에 시험 삼아 돌렸을 때는 포화 처리량이 61~83건/s로 더 낮았다(그 결과는
data/prelim/에 따로 두었고 본문 표에는 넣지 않았다). 절대값보다는 조건 사이의 차이를 보는 편이 맞다. - 반복 수가 적다. 부하 조건별 3회, 재시작 조건별 2~3회다. 손실 0이라는 결과는 “이 횟수에서 관찰되지 않았다”는 뜻이다.
- 한 번의 기동 실패. 21회 부하 실행 중 1회는 게이트웨이가 30초 안에 기동 로그를 남기지 못해 오케스트레이터가 중단했다. 원인은 찾지 못했고 같은 조건으로 다시 실행했다(
data/prelim/FAILED_*,logs/failed/). - 브로커는 amqtt 하나. 영속화를 지원하는 브로커나 클러스터 브로커에서는 재시작 결과가 달라질 것이다. 이번 결과는 “영속화 없는 브로커”의 동작이다.
- 보안 항목은 설계 논의다. TLS, 인증, ACL은 이 실험에서 켜지 않았고 그에 따른 성능 비용도 재지 않았다.
재현 방법
작업 폴더 fabiot/3/ 기준이다.
python3 -m venv venv
./venv/bin/pip install secsgem==0.3.0 amqtt==0.12.1 paho-mqtt==2.1.0 matplotlib
./run_load.sh                 # 7개 부하 조건 x 3회 (약 10분)
./run_restart.sh              # 브로커 재시작, 3개 모드 x 3회
./run_restart_slowsub.sh      # 구독자 늦은 재접속, 2개 모드 x 2회
./venv/bin/python src/analyze.py agg      # data/summary_load_agg.csv
./venv/bin/python src/analyze_restart.py  # data/summary_restart.csv
./venv/bin/python src/plot.py             # out/fab-iot-3-*.png
./venv/bin/python src/sizes.py            # HSMS 프레임 vs JSON 크기
- 각 실행은
src/orchestrate.py가 브로커 → 구독자 → 장비 → 게이트웨이 순으로 띄우고, 끝나면 SIGTERM(필요하면 SIGKILL)으로 전부 정리한다. - 원자료:
data/<실행명>/rx.csv(구독자 수신 기록),eq.json(장비 송신 로그, 시퀀스별 송신 시각),gw.json(게이트웨이 카운터, MQTT 접속 시각),run.json(브로커 kill/기동 시각, load average). - 장비 물리량 난수 시드는 42다. 처리량과 지연은 OS 스케줄링에 좌우되므로 같은 값이 나오지 않고, 반복 간 범위를 표에 함께 적었다.
- 포트는 HSMS 15000, MQTT 18883이고 모두
127.0.0.1에만 바인드한다.
References
- SEMI, “SEMI E5 - Specification for SEMI Equipment Communications Standard 2 Message Content (SECS-II)”, 스토어 초록 페이지. https://store-us.semi.org/products/e00500-semi-e5-specification-for-semi-equipment-communications-standard-2-message-content-secs-ii
- SEMI, “SEMI E37 - High-Speed SECS Message Services (HSMS) Generic Services”, 스토어 초록 페이지. https://store-us.semi.org/products/e03700-semi-e37-high-speed-secs-message-services-hsms-generic-services
- SEMI, “SEMI E30 - Specification for the Generic Model for Communications and Control of Manufacturing Equipment (GEM)”, 스토어 초록 페이지. https://store-us.semi.org/products/e03000-semi-e30-specification-for-the-generic-model-for-communications-and-control-of-manufacturing-equipment-gem
- SEMI, “SEMI E187 - Specification for Cybersecurity of Fab Equipment”, 스토어 초록 페이지. https://store-us.semi.org/products/e18700-semi-e187-specification-for-cybersecurity-of-fab-equipment
- secsgem 문서 (B. Parzella), HSMS messages / HSMS protocol. https://secsgem.readthedocs.io/en/latest/hsms/messages.html, https://secsgem.readthedocs.io/en/latest/hsms/protocol.html
- secsgem 0.3.0, PyPI. https://pypi.org/project/secsgem/ / 소스 https://github.com/bparzella/secsgem
- amqtt 0.12.1, PyPI 및 문서. https://pypi.org/project/amqtt/, https://amqtt.readthedocs.io/
- Eclipse Paho MQTT Python client 문서. https://eclipse.dev/paho/files/paho.mqtt.python/html/client.html
- OASIS, MQTT Version 3.1.1. https://docs.oasis-open.org/mqtt/mqtt/v3.1.1/os/mqtt-v3.1.1-os.html
- OASIS, MQTT Version 5.0. https://docs.oasis-open.org/mqtt/mqtt/v5.0/os/mqtt-v5.0-os.html
- NIST SP 800-82 Rev. 3, Guide to Operational Technology (OT) Security. https://csrc.nist.gov/pubs/sp/800/82/r3/final