[팹 IoT 연구 2] 장비 이상 감지(FDC) — 고정 한계, SPC, PCA 중 무엇이 덜 시끄럽게 잡나
이 글의 모든 수치는 합성(시뮬레이션) 데이터에서 나왔다. 실제 장비·팹 데이터는 쓰지 않았고, 센서 모델과 고장 크기는 내가 정했다. “실제 팹에서 무엇이 낫다”가 아니라 “이런 구조의 데이터에서는 이렇게 갈린다”는 관찰이다.
연구 질문
- 센서 트레이스에 계단 이동, 드리프트, 스파이크, 상관 깨짐을 넣으면 고정 한계 / SPC / 다변량(PCA·Isolation Forest) 은 각각 무엇을 잡고 놓치나.
- 그 대가로 오경보는 얼마나 늘어나나.
- 같은 데이터를 MQTT 로 흘리면 장비 한 대가 초당 몇 건, 몇 바이트를 내나.
배경 — 반도체 팹에서 이 문제
FDC(Fault Detection and Classification)는 웨이퍼 처리 중 압력·온도·RF 전력·가스 유량 같은 센서 값을 모아 “이번 런이 평소와 다르다”를 판단하는 일이다. 수집 쪽은 SEMI 표준이 다룬다. SEMI E134 는 장비에서 이벤트·예외·트레이스 데이터를 “이름 붙은 데이터 수집 계획(data collection plan)”으로 가져오는 방법을 규정한다(SEMI E134).
판단 방법은 크게 셋이다.
- 고정 한계: 설정값 ± 허용치를 샘플마다 검사한다. 즉시 반응하지만 허용치 안의 변화는 못 본다.
- SPC: 런마다 스텝별 요약 지표를 뽑아 정상 구간 기준 관리도를 그린다. Shewhart 관리도, 작은 이동에 민감한 EWMA(NIST e-Handbook 6.3.2.4), 연속 패턴을 보는 Western Electric(WECO) 규칙(NIST e-Handbook 6.3.2)이 대표적이다.
- 다변량: 지표 여러 개를 함께 본다. PCA 로 정상 데이터의 주성분 공간을 잡고, 그 안의 거리(Hotelling T², NIST 6.5.4.3)와 공간 밖 잔차(SPE, Q 통계량)를 감시한다. 식각 공정 FDC 에 PCA 계열을 비교한 연구로 Wise 등(1999)이 있고, 개관은 Qin(2003)이 정리했다. Isolation Forest(Liu 등, 2008)는 라벨 없는 트리 기반 이상치 점수다.
실험 설계
장비 모델. 플라즈마 식각 챔버 1대, 10 Hz, 4스텝 레시피(stabilize 10 s → ignite 5 s → main etch 30 s → over-etch 10 s), 런당 550 샘플, 센서 6개(압력, 유량, 스로틀 밸브 개도, ESC 온도, RF 순방향·반사). 설정값은 1차 지연으로 따라가고 스텝 전환 때 정합 과도로 반사전력이 튄다. 런 간 정상 변동으로 MFC 교정 편차(σ 3 %), RF 게인·정합 계수·온도 오프셋 편차, 시즈닝을 흉내 낸 반사전력의 완만한 정상 드리프트를 넣었다. 밸브 개도는 종속 변수다. 압력 제어가 밸브를 움직이므로 valve = 10 × flow / (pressure × pump_health) 로 두었고, 유량이 흔들리면 밸브도 따라 흔들린다.
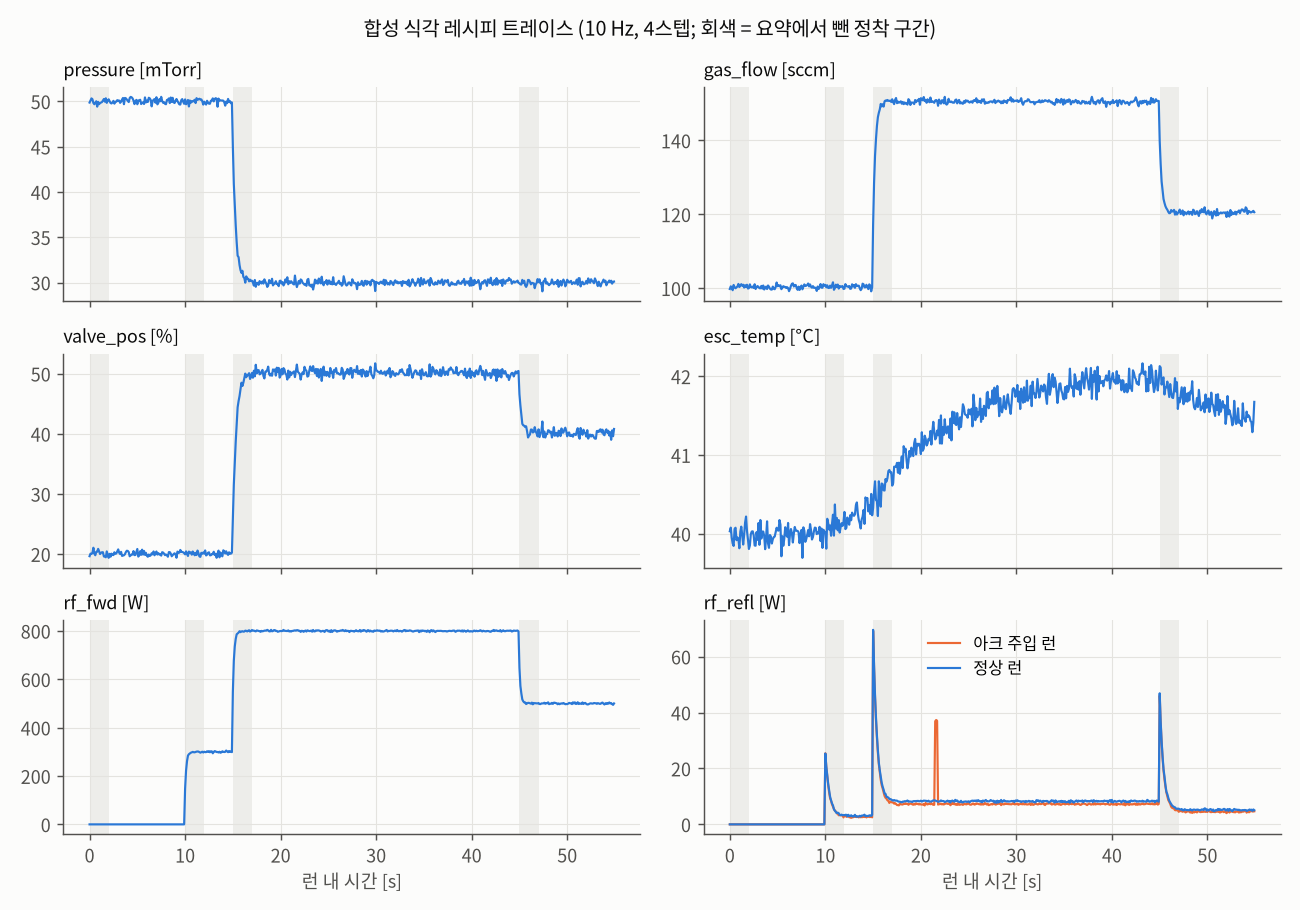
고장 4종 (학습 150런 뒤, 시험 200런 중 101번째 런부터):
| 고장 | 주입 방식 | 의도 |
|---|---|---|
| step | main etch 반사전력 +1.0 W 계단 (런 간 σ 약 0.4 W) | 지속적 평균 이동 |
| drift | main etch ESC 온도 런당 +0.01 °C | 냉각 열화 같은 느린 변화 |
| spike | 시험 후반 무작위 10런에 0.3 s 동안 반사전력 +30 W | 아크 같은 순간 이벤트 |
| corr_break | 펌프 건전성 1.00 → 0.98 | 압력·유량은 정상, 밸브만 약 1 %p 더 열림 |
요약 지표. 스텝마다 처음 2초(정착 구간)를 빼고 센서별 mean, std, max 를 구해 런당 72개(그중 6개는 RF 꺼진 스텝이라 상수, 실효 66개).
검출기 12종.
- 샘플 단위:
fixed_eng(압력·유량 ±10 %, 반사 25 W 미만 등 엔지니어링 허용치),fixed_tight5s(학습 스텝별 평균 ±5σ) - 지표별 SPC(하나라도 넘으면 경보):
shewhart_3s,shewhart_bonf(Bonferroni, ±4.12σ),ewma(λ=0.2, L=3),ewma_bonf(L=4.12),western_electric(WECO 1~4) - 다변량:
pca_theory(72개, 분산 90 %, T² F분포·SPE Jackson–Mudholkar 이론 한계 α=1 %),pca_cal(학습 150런을 적합 100 + 보정 50 으로 나눠 보정셋 99.5 % 분위수를 한계로),pca_cal_means(평균 지표 24개, 분산 99 %),iforest_cal(200트리, 보정셋 1 % 분위수) - 조합:
combo_fixed_pca= fixed_eng OR pca_cal_means
평가. 시드 10개 × 시나리오 5개(정상 포함). 오경보율(FAR)은 정상 시나리오 시험 200런 중 경보 비율, 검출률은 고장 런 중 경보 비율(런 단위 재현율), 지연은 고장 시작 후 첫 경보까지 런 수(못 잡으면 100으로 절단). 2코어 노드에서 메모리 1.5 GB·CPU 100 % 상한으로 약 2분 걸렸다.
PCA 핵심은 이렇다. 한계를 이론식이 아니라 적합에 쓰지 않은 정상 런에서 잡는다.
def pca_calibrated(Ftr, Fte, idx, var=0.90, q=0.995):
    A, C = Ftr[:N_FIT][:, idx], Ftr[N_FIT:][:, idx]   # 적합 100런 / 보정 50런
    mu, sd = A.mean(0), A.std(0, ddof=1) + 1e-12
    za, zc, zt = (A - mu) / sd, (C - mu) / sd, (Fte[:, idx] - mu) / sd
    pca = PCA(n_components=var, svd_solver="full").fit(za)
    lam = pca.explained_variance_
    def stat(Z):
        sc = pca.transform(Z)
        return (sc ** 2 / lam).sum(1), ((Z - pca.inverse_transform(sc)) ** 2).sum(1)
    t2c, spec = stat(zc); t2, spe = stat(zt)
    return (t2 > np.quantile(t2c, q)) | (spe > np.quantile(spec, q)), pca.n_components_
결과
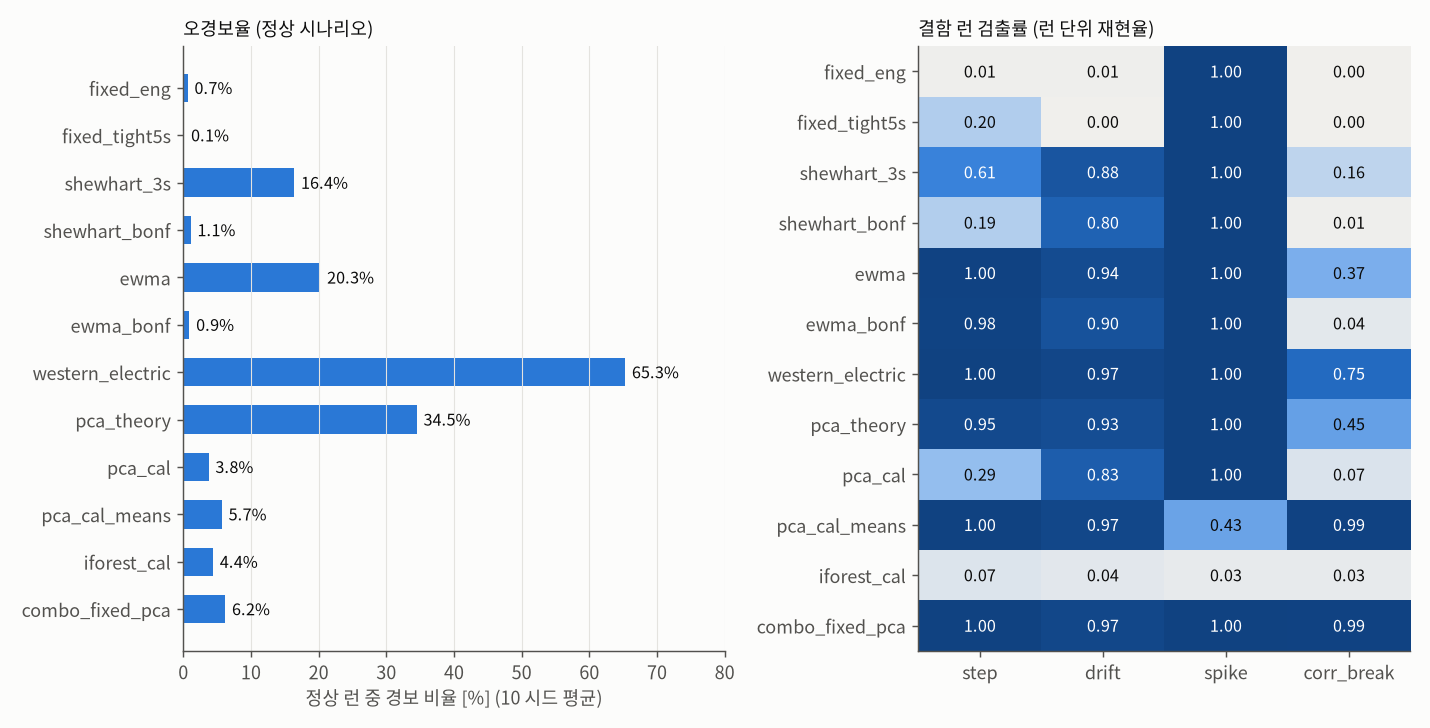
표 1. 오경보율과 고장별 검출률 (시드 10개 평균)
| 검출기 | FAR | 정상 1,000런당 경보 | step | drift | spike | corr_break |
|---|---|---|---|---|---|---|
| fixed_eng | 0.7 % | 7 | 0.01 | 0.01 | 1.00 | 0.00 |
| fixed_tight5s | 0.1 % | 2 | 0.20 | 0.00 | 1.00 | 0.00 |
| shewhart_3s | 16.4 % | 164 | 0.61 | 0.88 | 1.00 | 0.16 |
| shewhart_bonf | 1.1 % | 11 | 0.19 | 0.80 | 1.00 | 0.01 |
| ewma | 20.3 % | 203 | 1.00 | 0.94 | 1.00 | 0.37 |
| ewma_bonf | 0.9 % | 9 | 0.98 | 0.90 | 1.00 | 0.04 |
| western_electric | 65.3 % | 653 | 1.00 | 0.97 | 1.00 | 0.75 |
| pca_theory | 34.5 % | 345 | 0.95 | 0.93 | 1.00 | 0.45 |
| pca_cal | 3.8 % | 38 | 0.29 | 0.83 | 1.00 | 0.07 |
| pca_cal_means | 5.7 % | 57 | 1.00 | 0.97 | 0.43 | 0.99 |
| iforest_cal | 4.4 % | 44 | 0.07 | 0.04 | 0.03 | 0.03 |
| combo_fixed_pca | 6.2 % | 62 | 1.00 | 0.97 | 1.00 | 0.99 |
표 2. 지속 고장의 검출 지연 (런, 시드 10개 중앙값 [최소–최대], FAR 6.2 % 이하만)
| 검출기 | step | drift | corr_break |
|---|---|---|---|
| fixed_eng | 72.5 [3–100] | 99 [4–100] | 100 [57–100] |
| shewhart_bonf | 5 [0–23] | 15 [12–20] | 90 [17–100] |
| ewma_bonf | 1 [0–3] | 10.5 [8–12] | 63.5 [8–100] |
| pca_cal | 1.5 [0–26] | 10.5 [1–22] | 18.5 [1–100] |
| pca_cal_means | 0 [0–0] | 3 [0–5] | 0 [0–0] |
| combo_fixed_pca | 0 [0–0] | 3 [0–5] | 0 [0–0] |
FAR 이 높은 검출기(western_electric, pca_theory 등)는 지연이 0~2런으로 짧게 나오지만, 정상 런에서도 그만큼 자주 울리므로 그 지연은 “고장을 봤다”는 뜻이 아니다. 그래서 표 2 에서 뺐다.
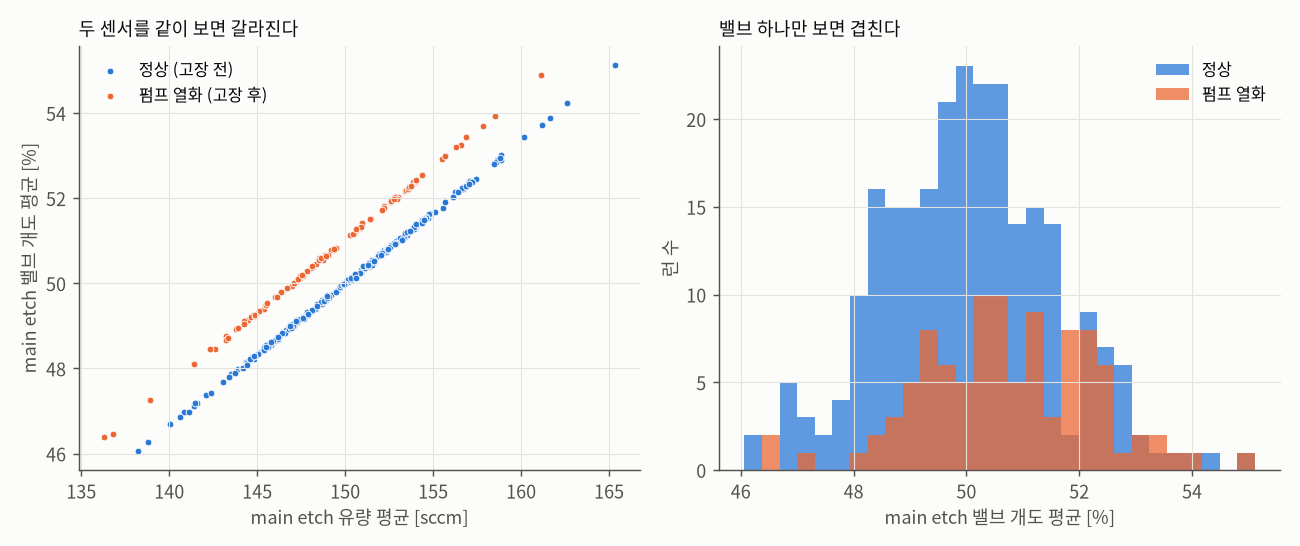
표 3. PCA 성분 수 민감도 (pca_cal 방식, 시드 10개 평균)
| 특성 | 분산 기준 | 평균 성분 수 | FAR | step | drift | corr_break |
|---|---|---|---|---|---|---|
| 72개 전부 | 90 % | 22.4 | 3.8 % | 0.29 | 0.83 | 0.07 |
| 72개 전부 | 99 % | 38.1 | 4.4 % | 1.00 | 0.91 | 0.19 |
| 평균 24개 | 90 % | 6.0 | 7.3 % | 0.31 | 0.85 | 0.10 |
| 평균 24개 | 99 % | 9.1 | 5.7 % | 1.00 | 0.97 | 0.99 |
표 4. 스트리밍 — 챔버 1대, 런 1개(55 s, 550 샘플)를 MQTT 5 로 보낼 때 (계산값, 네트워크 미사용)
| 방식 | 메시지/s | 평균 페이로드 | 런당 바이트 (QoS 0) | 런당 바이트 (QoS 1, PUBACK 포함) | 헤더 비중 (QoS 1) |
|---|---|---|---|---|---|
| A. 센서별 토픽 | 60 | 58.7 B | 284,923 | 304,723 | 36.5 % |
| A + Topic Alias | 60 | 58.7 B | 220,159 | 239,959 | 19.3 % |
| B. 샘플 묶음, 키 이름 풀어씀 | 10 | 232.2 B | 142,013 | 145,313 | 12.1 % |
| C. 샘플 묶음, 배열 압축 | 10 | 64.5 B | 47,013 | 50,313 | 29.5 % |
| D. 런 요약 72개 1건 | 0.018 | 2,323 B | 2,351 | 2,357 | 1.4 % |
바이트는 MQTT 5.0 패킷 구조(고정 헤더 + 가변 정수 Remaining Length, 토픽 2 B+길이, QoS>0 패킷 식별자 2 B, 속성 길이, Topic Alias 3 B, 무속성 PUBACK 4 B)로 셌다(MQTT 5.0 §1.5.5, §3.3, §3.4). TCP/TLS 는 제외. B 방식 예시:
{"tool":"ETCH01","chamber":"A","run":123,"wafer":"LOT0042-07","recipe":"OXIDE_ME_v3","step":"main_etch","seq":300,"ts":1760194830000,"pressure":30.07,"gas_flow":150.7,"valve_pos":50.57,"esc_temp":41.77,"rf_fwd":800.67,"rf_refl":8.35}
해석
1. 고정 한계는 순간 이벤트용이다. 0.3초 아크는 샘플 단위 한계가 모든 시드에서 잡았고 FAR 은 1 % 미만이었다. 샘플 도착 즉시 판정하므로 런 종료(55초)를 기다리지도 않는다. 대신 허용치 안의 계단·드리프트·상관 깨짐은 거의 못 봤다.
2. 단변량 규칙을 지표 수십 개에 걸면 경보가 쏟아진다. ±3σ 하나의 오경보 확률은 0.27 % 지만 실효 지표 66개를 OR 로 묶으면 1 − 0.9973⁶⁶ ≈ 16.3 %, 실측은 16.4 % 였다. WECO 규칙은 정상 런의 65 % 에서 울렸다. Bonferroni 보정만으로 Shewhart 1.1 %, EWMA 0.9 % 로 내려갔고, EWMA 는 그러고도 계단 이동을 0.98, 중앙 지연 1런으로 잡았다.
3. 이론 한계를 그대로 믿으면 안 된다. pca_theory 는 명목 1 % 두 개였는데 실측 FAR 이 34.5 % 였다. 150런으로 72차원 공분산을 추정하면 잔차 분산이 과소추정된다. 적합과 한계 설정을 나누자(pca_cal) 3.8 % 가 됐다. 명목보다 높은 건 보정셋 50런의 99.5 % 분위수가 사실상 최댓값 근처이기 때문이다.
4. 상관 깨짐은 같이 봐야 보이고, 무엇을 같이 보느냐가 결정적이다. 펌프 열화로 밸브 평균이 약 1 %p 올랐지만 정상 런 간 변동보다 작아 히스토그램이 겹친다. 유량과 함께 그리면 두 줄로 갈라진다. 그런데 72개 전부에 PCA 를 걸면 검출률이 0.07 이었다. std·max 같은 잡음성 지표가 잔차 공간을 채워 SPE 에 묻혔다. 평균 24개, 분산 99 % 로 바꾸자 유량–밸브 관계 방향만 잔차에 남아 0.99 가 됐다(표 3).
5. 만능은 없었다. pca_cal_means 는 평균만 보므로 스파이크를 0.43 만 잡았다. 샘플 단위 고정 한계와 OR 로 묶은 combo 가 네 고장 모두 0.97 이상, FAR 6.2 % 였다. Isolation Forest 는 거의 못 잡았다. 72차원에서 무작위 특성으로 분할하므로 고장이 한두 특성에만 실리면 그 특성이 분할에 잘 쓰이지 않는다. 또 spike 시나리오의 ewma_bonf FAR 은 39 % 였다. 스파이크 런의 max 지표가 표준화 값으로 약 67이라, EWMA 기억이 빠지는 십여 런 동안 정상 런까지 경보가 났다. 최댓값류 지표는 EWMA 에서 빼는 편이 낫다.
6. 경보 피로. 정상 1,000런당 경보로 바꾸면 western_electric 653건, combo 62건, ewma_bonf 9건이다. 운영·보안 알림을 사람이 분류해 본 사람이면 아는 그림이다. 하루 수백 건이면 사람은 읽지 않고 닫고, 진짜 고장도 같이 닫힌다. 이 클러스터의 감시 스크립트를 처음부터 “상태가 바뀔 때만 알린다”는 dedup 규칙으로 만든 것도, 파드 재시작 알림을 쫓아가 보니 원인이 같은 시각 컨트롤플레인 흔들림이었던 일도 같은 교훈이다. 여러 지표가 동시에 울리는 것을 한 사건으로 묶는 일이 FDC 의 C(분류)다. 검출기는 검출률과 함께 “정상일 때 얼마나 조용한가”로 재야 한다.
7. 스트리밍 설계. 센서별 토픽은 챔버당 초당 60건이고 바이트의 36.5 %(QoS 1)가 헤더와 PUBACK 이었다. 샘플 단위로 묶고 배열로 줄이면 10건/s, 런당 바이트가 약 1/6(304,723 → 50,313 B)이 된다. 런 요약만 보내면 2.4 KB 지만 순간 아크를 실시간으로 못 잡는다. 엣지에서 샘플 단위 한계를 돌리고 브로커로는 묶은 트레이스나 요약을 보내 서버의 다변량 모델이 받는 구성이 해석 1·5 와도 맞는다.
한계
- 전부 합성 데이터다. 잡음·고장 크기를 내가 정했으므로 검출률의 절대값은 의미가 없다.
- 결과를 보고 설계를 고쳤다. 첫 실행에서 정착 구간이 짧아 고정 한계가 정상 런에서도 100 % 울렸고, 압력 시정수·정착 구간·정상 드리프트 크기를 조정했다. pca_cal_means 의 설정도 표 3 스윕을 보고 골랐다. 같은 고장 데이터로 고르고 평가했으므로 낙관적으로 편향됐을 수 있다.
- 고장은 한 번에 하나, 챔버·레시피 하나. PM 후 기준선 변화나 고장 중첩은 없다. 분류는 하지 않았다.
- 학습 150·보정 50런은 작아 명목 FAR 을 맞추지 못했다.
- MQTT 바이트는 패킷 구조 계산값이다. 브로커 처리량·압축·배치 전송은 재지 않았다. 지연은 런 단위이며 시간으로 바꾸지 않았다.
재현 방법
sim.py(시뮬레이터·검출기 → results/runs_raw.csv), probe_var.py(PCA 스윕), aggregate.py(→ summary.csv), stream.py(→ stream_sizes.csv), plots.py(그림), run.sh(전체 실행). 버전은 numpy 2.5.4, scikit-learn 1.9.1, scipy 1.18.1, matplotlib 3.11.2. 난수는 np.random.default_rng([seed, fault_index]), seed 0~9.
python3 -m venv venv && venv/bin/pip install -r requirements.txt
./run.sh   # 각 단계를 systemd-run MemoryMax=1500M, CPUQuota=100% 로 감싸 실행
References
- SEMI, SEMI E134 — Specification for Data Collection Management. https://store-us.semi.org/products/e13400-semi-e134-specification-for-data-collection-management
- NIST/SEMATECH, e-Handbook of Statistical Methods, 6.3.2 What are Variables Control Charts? (WECO 규칙). https://www.itl.nist.gov/div898/handbook/pmc/section3/pmc32.htm
- NIST/SEMATECH, e-Handbook of Statistical Methods, 6.3.2.4 EWMA Control Charts. https://www.itl.nist.gov/div898/handbook/pmc/section3/pmc324.htm
- NIST/SEMATECH, e-Handbook of Statistical Methods, 6.5.4.3 Hotelling’s T squared. https://www.itl.nist.gov/div898/handbook/pmc/section5/pmc543.htm
- OASIS, MQTT Version 5.0, OASIS Standard, 2019. https://docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html
- scikit-learn,
sklearn.decomposition.PCA. https://scikit-learn.org/stable/modules/generated/sklearn.decomposition.PCA.html - scikit-learn,
sklearn.ensemble.IsolationForest. https://scikit-learn.org/stable/modules/generated/sklearn.ensemble.IsolationForest.html - J. E. Jackson, G. S. Mudholkar, “Control Procedures for Residuals Associated With Principal Component Analysis,” Technometrics 21(3), 1979. doi:10.1080/00401706.1979.10489779
- B. M. Wise, N. B. Gallagher, S. W. Butler, D. D. White Jr., G. G. Barna, “A comparison of principal component analysis, multiway principal component analysis, trilinear decomposition and parallel factor analysis for fault detection in a semiconductor etch process,” Journal of Chemometrics 13(3–4), 1999.
- F. T. Liu, K. M. Ting, Z.-H. Zhou, “Isolation Forest,” Proc. IEEE ICDM, 2008. doi:10.1109/ICDM.2008.17
- S. J. Qin, “Statistical process monitoring: basics and beyond,” Journal of Chemometrics 17(8–9), 2003. doi:10.1002/cem.800