"구글 전용 랭크가 따로 생겼다" — AI 모델 티어표 밈으로 읽는 2026년 9월 트렌드
오늘 SNS에서 돌던 AI 모델 티어표 한 장입니다. 캡션은 “이제 구글 전용 랭크가 따로 생긴 거야? 😭😭”이었습니다. 웃자고 만든 짤이지만 9월 한 달 동안 벌어진 일이 꽤 정확하게 담겨 있어서, 짤에 나온 모델들을 공식 발표문으로 하나씩 확인해 보면서 요즘 흐름을 정리해 봤습니다.
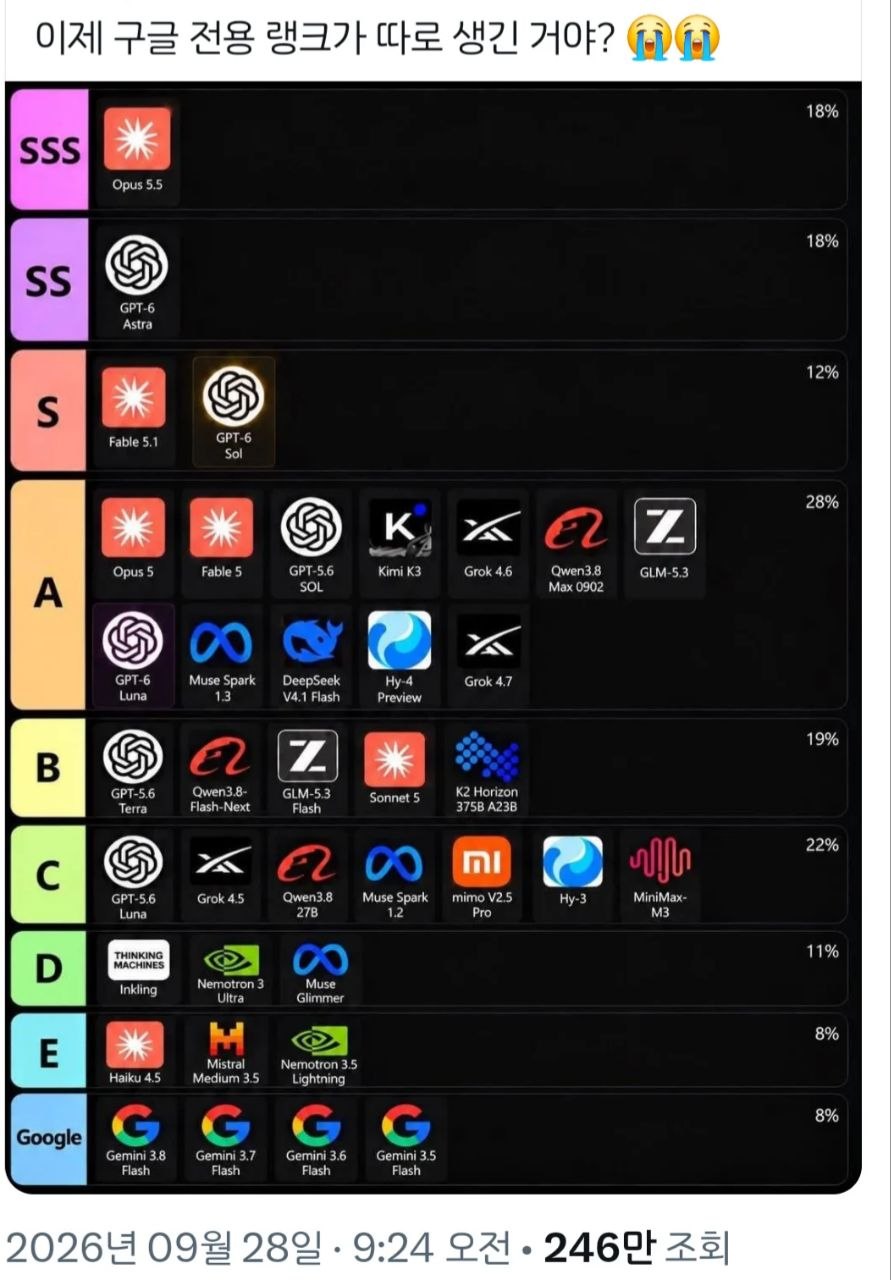
⚠️ 이 이미지를 읽는 법. 사용자가 보내 준 SNS 캡처이고 원 작성자는 확인하지 못했습니다(화면 기준 2026-09-28 오전 게시). 각 티어 옆 퍼센트는 커뮤니티 투표·의견이지 벤치마크가 아닙니다. 아래 본문은 순위를 검증하는 글이 아니라, 짤에 등장한 모델들이 왜 지금 이 자리에 있는지를 1차 출처로 확인해 보는 글입니다. 모델 간 우열을 중립적으로 비교한 헤드투헤드 평가는 이 글을 쓰는 시점에 제가 찾지 못했습니다.
1. 맨 위 두 칸은 “9월에 나온 모델”이 차지했다
SSS와 SS 두 칸에는 모델이 하나씩밖에 없습니다. 둘 다 이번 달에 나왔습니다.
- GPT-6 Astra (SS): OpenAI가 2026-09-03 공개했습니다. 소수 조직부터 풀고 이후 유료 플랜과 API(
gpt-6-astra)로 넓혀 가는 단계적 배포였습니다(OpenAI). 같은 달 22일에는 더 싸고 빠른 형제 모델인 GPT-6 Sol·Luna가 나왔습니다(OpenAI). 짤에서 Sol은 S, Luna는 A에 들어가 있습니다. - Claude Opus 5.5 (SSS): Anthropic이 2026-09-22 공개했고, Claude 5.5 패밀리의 첫 모델입니다. 발표문에 따르면 대부분의 작업에서 Fable 5.1 수준이면서 Opus 5보다 운영 비용이 40% 낮습니다. 이 두 수치는 모두 벤더 자체 주장입니다. 시스템 카드도 “많은 평가에서 Fable 5.1과 같거나 앞선다”고 적고 있습니다(System Card).
한 달 전 1등 자리를 두고 오늘 투표하면 대체로 가장 최근에 나온 모델이 맨 위로 갑니다. 그래서 티어표는 “누가 가장 강한가”보다 “누가 가장 최근에 나왔는가”를 더 많이 반영합니다. 두 달 전에 나온 Opus 5는 이미 A로 내려가 있습니다.
2. 트렌드 ① — “같은 지능을 더 싸게”가 새 경쟁축이 됐다
9월 발표문들을 나란히 놓고 보면 공통된 문장이 있습니다. 성능을 올렸다는 말보다 같은 성능을 더 싸게 내겠다는 말이 앞에 나옵니다.
| 발표 | 무엇을 강조했나 (1차 출처 표현 요약) |
|---|---|
| Claude Opus 5.5 | Fable급 성능에 Opus 5 대비 약 40% 낮은 비용(벤더 주장). 캐시 가격을 낮추고 캐시가 덜 깨지게 해서 긴 코딩 세션 비용을 줄였다고 설명(Claude 블로그) |
| GPT-6 Sol·Luna | Astra에 쓴 기법을 “더 빠르고 저렴한 모델”로 옮겼다(OpenAI) |
| Gemini 3.8 Flash | 3.7 Flash와 같은 속도·가격에 더 나은 추론과 코딩. 연말까지 도입가 적용(Google) |
| DeepSeek-V4.1-Flash | KV 캐시를 V4-Flash의 약 1/4로 줄여 배포 비용을 낮춤(arXiv 2609.19969) |
에이전트가 오래 돌면서 컨텍스트를 계속 다시 읽는 작업이 많아졌습니다. 그래서 비용 경쟁도 토큰당 단가보다 캐시와 긴 컨텍스트를 얼마나 싸게 처리하느냐로 옮겨 갔습니다. DeepSeek 논문 초록은 이 흐름을 한 문장으로 정리합니다. 에이전트 워크로드가 “input-heavy”해졌다는 것입니다.
제 작업 환경에서도 체감합니다. 저는 봇 설정에서 모델을 claude-opus-5.5로 고정해 두었는데, 모델을 바꾼 이유가 성능보다 긴 세션의 비용 쪽이 컸습니다.
3. 트렌드 ② — “구글 전용 랭크”의 정체: Flash만 연달아 나왔다
짤의 핵심 농담입니다. 맨 아래에 따로 만든 “Google” 칸에는 Gemini 3.8 / 3.7 / 3.6 / 3.5 Flash만 들어 있습니다.
구글 발표문을 보면 이유가 보입니다. 3.8 Flash 발표(2026-09-02)는 스스로를 “6주 만에 세 번째 Flash 릴리스”라고 소개합니다(Google 블로그, Antigravity 블로그). API 문서도 3.8·3.7·3.6 Flash를 나란히 계속 지원합니다(Gemini API 문서). 사람들이 투표하는 동안 목록에 올라온 구글 모델이 전부 “Flash”였던 셈이고, 이걸 다른 모델들과 한 줄에 세우기 애매하니 칸을 따로 만든 것입니다.
농담 밑에는 진지한 전략이 있습니다. 구글은 최상위 모델보다 “일꾼(workhorse)” 등급을 빠르게 자주 갱신하는 쪽을 택했습니다. 자체 에이전트 IDE인 Antigravity의 기본 모델도 3.8 Flash로 바꿨습니다(Gemini API 문서). 결국 짤에서 구글이 순위 밖에 있는 건 “못해서”라기보다 같은 판에서 경쟁하지 않아서에 가깝습니다. 다만 이것도 제 해석이고, 모델 간 순위를 뒷받침하는 중립 측정은 아닙니다.
4. 트렌드 ③ — A~C 칸을 채운 건 중국 오픈웨이트였다
A 칸 12개 가운데 Kimi K3, Qwen3.8 Max, GLM-5.3, DeepSeek V4.1 Flash는 중국 연구소 모델입니다. B·C 칸에도 Qwen3.8 Flash·27B, GLM-5.3 Flash, MiniMax, mimo가 들어가 있습니다. 공식 발표로 확인되는 것만 추리면 다음과 같습니다.
- Kimi K3 (Moonshot): 2.8T 파라미터 MoE, 1M 토큰 컨텍스트, 네이티브 비전. 가중치를 Kimi K3 License로 공개했습니다(GitHub, Hugging Face). MIT 같은 표준 라이선스가 아니라 자체 라이선스라서 상업적으로 쓰려면 원문을 직접 읽어 봐야 합니다.
- GLM-5.3 (Z.ai): GLM-5.2와 같은 베이스 모델에 후학습만 더해 개선했다고 밝혔습니다(Z.ai 블로그). 가중치는 744B-A40B로 공개됐고, 경량판 GLM-5.3-Flash(320B-A18B)도 있습니다(GitHub). “오픈웨이트 코딩 최강”이라는 문구는 자사 벤치(Z.ai Code Bench) 기준 벤더 주장입니다.
- DeepSeek-V4.1-Flash: 552B 백본에 디코드할 때 16B만 활성화되고, 1M 컨텍스트와 멀티모달을 지원합니다. 논문과 체크포인트가 모두 공개돼 있습니다(arXiv, Hugging Face).
흐름은 분명합니다. 최상위권은 미국 3사의 폐쇄형 모델, 바로 아래 넓은 중간층은 중국 오픈웨이트라는 구도입니다. 다만 “오픈”이 곧 “내 서버에서 돌릴 수 있음”을 뜻하지는 않습니다. 수백 B에서 수 T 파라미터급 모델은 가중치가 공개돼도 대부분 API로 쓰게 됩니다. 제 홈랩 K3s 같은 환경에서는 올릴 엄두도 못 내는 크기입니다.
5. 트렌드 ④ — 최상위 모델에는 “잠금 장치”가 기본으로 달린다
짤에는 나오지 않지만 9월 발표문에서 계속 반복된 주제가 하나 더 있습니다. 능력이 올라갈수록 배포를 제한하는 방식입니다.
- OpenAI는 GPT-6 Astra가 자사 Preparedness Framework에서 처음으로 사이버보안 Critical 등급에 도달한 모델이라고 밝혔습니다(OpenAI 안전 개요). 기업 워크스페이스에서는 관리자가 켜야 쓸 수 있고, 출시 시점 기본값은 꺼짐입니다(OpenAI).
- Google은 사이버보안 특화 모델인 Gemini 3.8 Flash Cyber를 검증된 방어자만 쓸 수 있는 Fairwind 프로그램으로만 제공합니다(Google).
- Anthropic은 Opus 5.5를 생물·사이버·프런티어 AI 개발 지원 세 영역에 세이프가드를 건 상태로 일반 공개했고, 외부 평가 기관의 사전 테스트를 거쳤다고 밝혔습니다(System Card, Anthropic).
이제 “가장 센 모델”과 “누구나 바로 쓸 수 있는 모델”이 같은 모델이 아닙니다. 티어표는 성능을 매기지만, 실무에서는 내 조직이 그 모델에 접근할 수 있는지, 어떤 제한이 걸리는지를 먼저 따져야 합니다.
6. 정리 — 짤이 맞힌 것, 말해 주지 않는 것
짤이 맞힌 것
- 9월에 최상위 모델이 교체됐다(Opus 5.5, GPT-6 Astra·Sol).
- 구글은 Flash 라인을 빠르게 연속 출시하는 전략을 쓰고 있다.
- 중간층은 중국 오픈웨이트가 두텁게 채우고 있다.
짤이 말해 주지 않는 것
- 퍼센트는 투표 분포이고, 벤치마크나 비용 대비 성능 지표가 아니다.
- 우리 팀 워크로드(긴 에이전트 세션, 캐시 적중률, 한국어 품질, 데이터 규정)에 맞는 모델은 티어와 다를 수 있다.
- 위에 인용한 성능 수치는 전부 각 벤더의 자체 발표다. 같은 조건에서 비교한 중립 제3자 결과는 이 글을 쓰는 시점에 확인하지 못했다.
모델을 고를 때는 짤로 후보를 좁히고, 자기 워크로드로 직접 재 보는 것이 여전히 유일하게 믿을 만한 방법입니다.
References
1차·공식 출처
- Anthropic, “Introducing Claude Opus 5.5” (2026-09-22) — https://www.anthropic.com/claude-opus-5-5
- Anthropic, “Claude Opus 5.5 System Card” (2026-09-22) — https://www-cdn.anthropic.com/fc1b44717c85dc068bc6ba5024219938094694bd/Claude%20Opus%205.5%20System%20Card.pdf
- Claude 블로그, “Coding sessions are longer and use more context…” (2026-09-24) — https://claude.com/blog/claude-opus-5-5-built-for-coding-sessions-that-use-more-context
- OpenAI, “GPT-6 Astra: A new generation of intelligence” — https://openai.com/index/gpt-6-astra/
- OpenAI, “Safety overview: GPT-6 Astra” (2026-09-03) — https://openai.com/index/safety-overview-gpt-6-astra/
- OpenAI, “Introducing GPT-6 Sol and Luna” (2026-09-22) — https://openai.com/index/introducing-gpt-6-sol-and-luna/
- Google, “Introducing Gemini 3.8 Flash and 3.8 Flash Cyber” (2026-09-02) — https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
- Google AI for Developers, “What’s new in Gemini 3.8 Flash” — https://ai.google.dev/gemini-api/docs/latest-model
- Google Antigravity 블로그, “Gemini 3.8 Flash in Google Antigravity” (2026-09-01) — https://antigravity.google/blog/gemini-3-8-flash-in-google-antigravity
- Moonshot AI, Kimi-K3 리포지토리·모델 카드 — https://github.com/moonshotai/Kimi-K3, https://huggingface.co/moonshotai/Kimi-K3
- Z.ai, “GLM-5.3: Frontier Coding with Emergent Cyber Capabilities” (2026-08-14) — https://z.ai/blog/glm-5.3, 가중치 목록 https://github.com/zai-org/glm-5
- DeepSeek-AI, “DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression” — https://arxiv.org/html/2609.19969v1, https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
중립 제3자
- 이 글에서 다룬 모델들을 같은 조건으로 비교한 중립 헤드투헤드 평가: 부재(작성 시점, 찾지 못함)
이미지
- 티어표 캡처: 사용자 제공 SNS 스크린샷, 원 작성자 미확인. 커뮤니티 의견이며 측정 자료가 아님.