Dream-RSI 그림 한 장 읽기 — 지난 탐색 기록 위에서 '꿈꾸며' 탐색 정책을 고친다
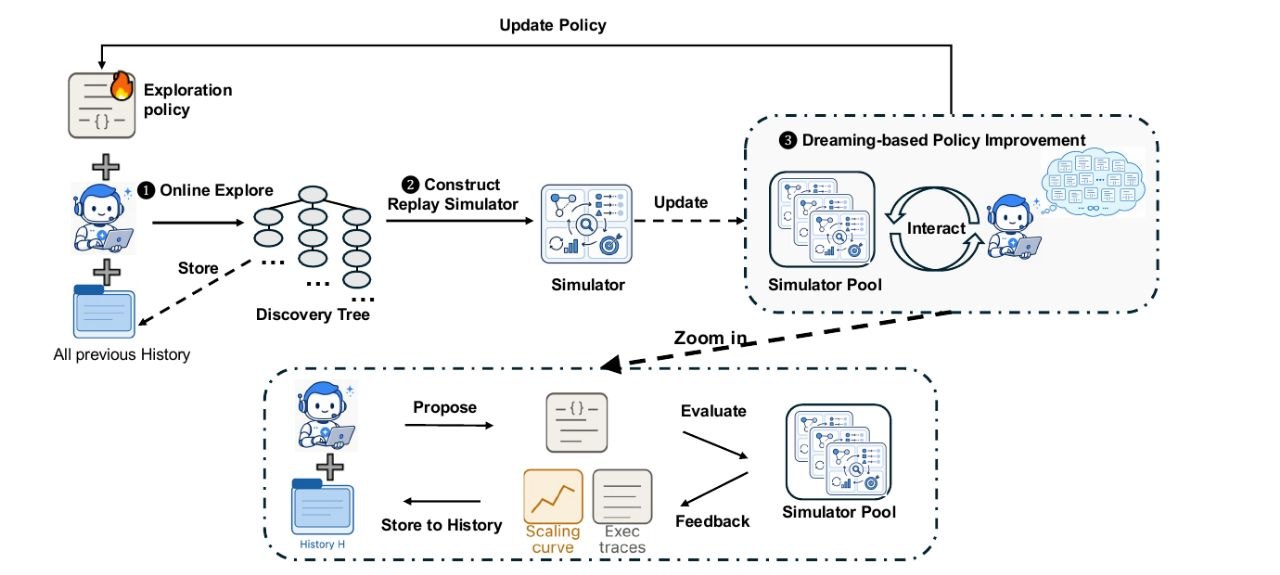
위 그림은 2026년 9월 14일 arXiv 에 올라온 Dream-RSI: Recursive Self-Improvement through Evolving Worlds (arXiv:2609.14858) 의 Figure 1 이다. 저자는 Google, Google DeepMind, University of Maryland, University of Virginia 소속이다 (프로젝트 페이지).
한 줄로 요약하면 이렇다.
이미 돌려 본 탐색 기록을 시뮬레이터로 삼아, 비싼 실행 없이 “탐색 정책” 코드를 여러 번 고쳐 보고, 제일 나은 것만 다시 실전에 투입한다.
무엇을 개선하는가 — 모델이 아니라 “탐색 정책 코드”
코딩 에이전트로 알고리즘·커널·수학 문제의 더 좋은 해를 찾는 시스템(논문은 SimpleTES 같은 기존 방식과 비교한다)은 보통 “어느 후보를 더 파고, 몇 개를 병렬로 돌릴지” 를 고정된 전략으로 정한다. 논문은 이 부분을 실행 가능한 탐색 정책(exploration policy) 코드로 떼어 내고, 오직 이것만 바꾼다. 논문 3절의 표현으로는 “Only the exploration-policy code changes; the underlying models, evaluator, and execution interfaces remain fixed.” (arXiv HTML §3)
그림 왼쪽 위의 불꽃 붙은 문서 아이콘 Exploration policy 가 바로 그 코드다. 불꽃은 “이게 학습(수정) 대상” 이라는 표시로 읽으면 된다. 로봇(코딩 에이전트)과 All previous History 는 옆에 + 로 붙어 있을 뿐, 그 자체는 바뀌지 않는다.
① Online Explore — Discovery Tree 를 키운다
현재 정책이 코딩 에이전트를 움직여 Discovery Tree 를 만든다.
- 루트는 초기 작업공간이다. 매 라운드 정책이 루트와 현재 리프 중 최대 W 개를 골라 배치로 넘긴다.
- 에이전트는 고른 노드의 작업공간을 이어받아 후보를 하나 만들고, 평가기가 점수를 매긴다. 시도 하나가 자식 노드 하나가 된다.
- 각 노드에는 파일시스템 스냅샷, 생성물, 평가 진단, 점수가 기록된다.
- 정책이 빈 배치를 내거나 라운드 한도에 닿으면 멈춘다. 완성된 트리는 히스토리에 쌓인다 (그림의 Store 점선 화살표).
이 단계가 비싼 단계다. 노드 하나마다 LLM 호출과 실제 실행·평가가 들어간다.
② Construct Replay Simulator — 트리를 “되감을 수 있는 세계” 로
핵심 통찰이 여기 있다. 초록의 표현으로 “accumulated discovery history can serve as a replay simulator over the realized search space.” (arXiv:2609.14858)
트리의 모든 노드 결과가 이미 저장돼 있으므로, 새 정책을 이 트리 위에서 돌리면 “이 노드를 고르면 무엇이 나오는가” 를 다시 실행하지 않고 기록에서 꺼내 답할 수 있다. 리플레이는 새 후보를 생성하지 않고, 고른 노드의 기록된 자식을 정해진 순서대로 결정적으로 드러낸다 (§3). 논문 Figure 2 설명: “a single costly online run enables thousands of rapid, zero-execution-cost off-policy evaluations.”
그림에서 점선 Update 화살표가 Simulator Pool 로 가는 이유가 이것이다. 매 라운드 새 트리가 풀에 추가되어 “세계” 가 점점 넓어진다. 제목의 Evolving Worlds 가 이 뜻이다.
③ Dreaming-based Policy Improvement — 풀 안에서 정책을 여러 번 고친다
오른쪽 점선 박스다. 별도의 LLM 기반 “정책 개발 에이전트” 가 정책 코드를 M 번 고쳐 쓰고, 각 버전을 히스토리의 모든 트리에 리플레이해 평균 점수를 낸다. 에이전트는 리플레이 궤적과 점수, 이전 수정들의 피드백을 보고 다음 버전을 쓴다. 구름 속 수많은 문서 아이콘이 이렇게 “꿈에서” 만들어 본 후보 정책들이다.
리플레이 점수(논문 식 (1))는 세 항으로 이뤄진다.
- 발견 품질: 도달한 최고 점수
- 실행 비용: 드러낸 노드 수 N 에 비례하는 감점 (β₁·N)
- 병렬성 보너스: 라운드당 노드 수 (β₂·N / 라운드 수)
마지막에 평균 리플레이 점수가 가장 높은 버전을 고른다. 현재 정책도 후보에 포함되므로, 선택된 정책은 고정된 히스토리 위에서는 현재 정책보다 나쁘지 않다고 논문은 말한다. 그리고 맨 위 Update Policy 화살표로 다시 ① 에 투입된다. 이렇게 한 바퀴가 돈다.
아래 Zoom-in 박스 — ③ 의 안쪽 루프
그림 하단은 ③ 을 확대한 것이다. 그림에 적힌 그대로 읽으면:
- Propose — 에이전트가 히스토리 H 를 참고해 새 정책 코드(
{ }문서)를 제안한다. - Evaluate — Simulator Pool 에서 리플레이로 평가한다.
- Feedback — 그림에는 Scaling curve 와 Exec traces 두 가지가 피드백으로 그려져 있다. 본문 3절이 말하는 “리플레이 궤적과 점수” 에 해당하는 것으로 읽힌다.
- Store to History — 결과를 H 에 쌓고 다음 제안에 쓴다.
(※ 그림의 “scaling curve” 라는 표현이 본문 어디에 어떻게 정의되는지는 확인하지 못했다. 위 대응은 그림과 §3 본문을 맞춰 본 해석이다.)
얼마나 효과가 있다고 하나 (저자 주장)
아래는 모두 논문 저자들이 보고한 수치다. 제3자의 재현은 아직 찾지 못했다. 논문 1절 기준 (arXiv HTML):
- Lasso 정규화 경로 알고리즘: sklearn 등 표준 라이브러리와 강한 베이스라인을 능가하면서, 에이전트 호출을 SimpleTES 대비 최대 162배, 고정 탐색 베이스라인 대비 1.7배 줄였다.
- 수학 최적화 과제: 1k 생성 안에서 강한 베이스라인과 같거나 더 좋고, SimpleTES 대비 50배 이상 예산 절감.
- KernelBench (GPU 커널): 목표 속도에 1.79–2.43배 적은 생성으로 도달하거나, 커널 성능을 최대 2.09배 개선했다.
§4.1 의 Lasso 표에서 Gemini-3.1-Pro 기준 Dream-RSI 는 평균 실행시간 2931.0 ms에 호출 317회였고, SimpleTES 는 3804.8 ms에 호출 51,200회였다. 162배는 51,200 / 317 ≈ 161.5 에서 나온 값이다.
다만 모든 과제에서 이긴 건 아니다. Table 1 의 Auto Correlation(낮을수록 좋음)에서는 Dream-RSI(1.456375)가 고정 탐색(1.456001)과 SimpleTES(1.453675)보다 나빴고, Circle Packing 은 세 방식이 같은 값이었다. 초록도 “several settings” 에서 비용을 크게 줄였다고 조심스럽게 쓴다.
읽으면서 든 생각 — 한계가 곧 설계 이유다
리플레이 시뮬레이터는 이미 가 본 곳만 재현한다. 논문 §3은 리플레이가 기록된 트리 밖의 결과를 만들어 내지 않는다고 명시한다. 기록에 없는 가지를 고르는 정책은 꿈속에서 제대로 평가받지 못한다. 프로젝트 페이지의 표현으로는 “a policy can only be dreamt where history actually went” 이다.
그래서 Dream-RSI 는 한 번 꿈꾸고 끝나지 않는다. 실전(①) → 세계 확장(②) → 꿈(③) → 실전 루프를 계속 돌려 시뮬레이터 풀을 넓혀 가야 한다. 그림이 커다란 순환 화살표로 그려진 이유다.
실무 관점에서 가져갈 교훈은 단순하다. 에이전트 실행 로그를 버리지 말 것. 결과가 저장된 탐색 로그는 그 자체로 오프라인 평가 환경이 된다. 새 전략을 비싼 온라인 실행 없이 먼저 걸러 낼 수 있다.
References
- Zheng, T. et al. Dream-RSI: Recursive Self-Improvement through Evolving Worlds. arXiv:2609.14858, 2026. abs · HTML
- Dream-RSI 프로젝트 페이지 (저자 운영): https://dream-rsi.com/
- 공식 코드 저장소: https://github.com/zhengkid/Dream-RSI