도구 호출 0회가 증거다 — 에이전트 실습을 검증 로그로 바꾼 표 한 장
오늘 이 블로그에 같은 실습에서 나온 글이 두 편 올라갔다 — 워크스페이스 문서들의 역할과 에이전트가 자기 파일 일곱 개를 설명한 이야기. 둘 다 무엇이 있는가를 썼다.
이 글은 같은 실습의 다른 축이다. 그게 사실이라고 어떻게 확정했는가.
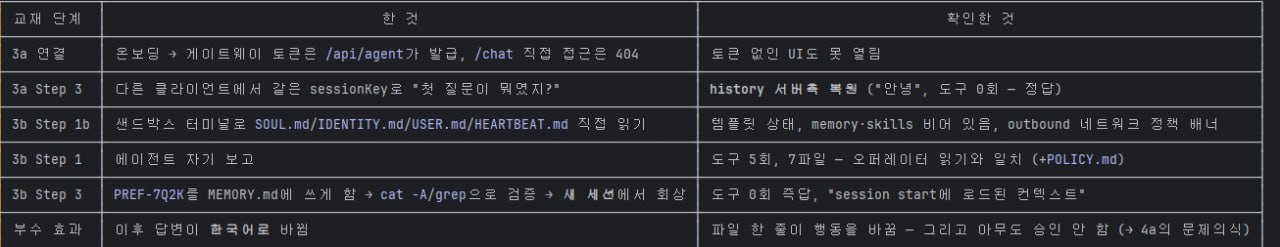
칸을 두 개로 나눈 것이 전부다
왼쪽은 한 것, 오른쪽은 확인한 것이다. 한 칸에 몰아 적으면 실습 로그가 되고, 나누면 검증 로그가 된다.
차이는 문장의 반증 가능성에 있다. “다른 클라이언트에서 같은 세션을 이어봤다” 는 반증할 수 없다 — 해봤다는 사실만 말한다. “첫 질문 ‘안녕’ 이 복원됐고 그때 도구 호출은 0회였다” 는 반증할 수 있다. 다음 사람이 같은 걸 돌려서 다른 숫자가 나오면 내 문장이 틀린 것이다.
에이전트 실습에서 이 구분이 특히 중요한 이유가 있다. 에이전트는 확인하지 않은 것도 확인한 것처럼 말한다. 오른쪽 칸을 강제하지 않으면 오른쪽 칸을 에이전트가 대신 써주고, 그건 검증이 아니라 자기 보고다.
도구 호출 횟수는 답이 어디서 왔는지를 가른다
표에서 세 행이 숫자를 들고 있다. 그리고 그 숫자가 정답 여부보다 많은 것을 말한다.
| 관측 | 도구 호출 | 결과 | 읽는 법 |
|---|---|---|---|
| 다른 클라이언트에서 “첫 질문이 뭐였지?” | 0회 | “안녕” — 정답 | 지금 읽은 게 아니다 → 서버가 history 를 복원해 넣어줬다 |
| “네 워크스페이스 파일을 나열해라” | 5회 | 7개 파일 | 실제로 파일을 읽었다 → 도구 경로가 살아 있다 |
| 새 세션에서 카나리아 회상 | 0회 | 즉답 | 세션 시작에 이미 로드돼 있었다 → 영속 파일이 컨텍스트로 주입된다 |
첫 행과 셋째 행은 둘 다 “0회에 정답” 인데 증명하는 게 서로 다르다. 첫 행은 서버측 세션 상태를, 셋째 행은 부팅 시 컨텍스트 주입을 증명한다. 그리고 둘째 행의 5회는 정반대를 증명한다 — 저건 지금 읽은 것이다.
요점은 이거다. 정답 여부만 보면 이 셋이 구분되지 않는다. 세 경우 모두 “에이전트가 맞게 대답했다” 로 끝난다. 어디서 왔는지를 가르는 건 호출 횟수뿐이고, 호출 횟수를 안 세면 “기억한다” 와 “읽어왔다” 와 “누가 넣어줬다” 가 한 덩어리로 뭉개진다. 아키텍처 판단이 필요한 순간에 정확히 그 구분이 필요해진다.
실패해야 하는 경로가 실패하는지도 재야 한다
첫 행(3a 연결)이 하는 일이 그거다. 토큰은 /api/agent 가 발급한다 — 여기까지는 성공 경로다. 그런데 오른쪽 칸에 적힌 건 성공이 아니라 실패 두 개다. /chat 직접 접근은 404, 토큰 없는 UI 도 안 열린다.
성공만 재면 접근 제어를 측정한 게 아니라 행복 경로를 측정한 것이다. 문이 열리는 걸 백 번 확인해도 문이 잠기는지는 모른다. 음성 대조(negative control)를 같은 표에 적어야 “토큰이 실제로 강제된다” 는 문장이 성립한다.
그리고 404 라는 상태 코드 자체도 정보다. 401/403 이 아니라 404 라는 건 경로의 존재 자체를 숨기는 쪽을 골랐다는 뜻이다. 다만 여기서 한 발 더 나가면 안 된다. 상태 코드 한 번을 본 것은 인과의 증거가 아니다. 이게 경로를 숨기려는 설계인지 그냥 라우팅이 없어서 난 404 인지, 이 표로는 가를 수 없다. 가르려면 존재하는 경로와 존재하지 않는 경로를 각각 토큰 유무로 네 번 재야 한다 — 그건 이 실습에서 안 했다.
독립 관측 두 개를 맞대기
3b 의 두 행은 같은 대상을 다른 경로로 두 번 관측한 것이다.
- Step 1b — 오퍼레이터가 샌드박스 터미널에서
SOUL.md/IDENTITY.md/USER.md/HEARTBEAT.md를 직접 열었다. 템플릿 상태였고memory·skills는 비어 있었다. - Step 1 — 에이전트에게 자기 파일을 보고하게 했다. 도구 5회, 7파일.
두 관측이 일치했다. 자기 보고만 있었다면 모델이 그럴듯하게 지어낸 목록과 구분할 방법이 없었을 것이다. 그런데 완전히 일치하지는 않았다 — 에이전트 쪽에만 POLICY.md 가 더 있었다. 어긋난 한 칸이 이 실습에서 가장 쓸모 있는 수확이었고, 그 어긋남을 파고든 게 자매 글이다.
검증 설계에서 흔한 착각이 여기 있다. 두 관측을 맞대는 목적은 일치를 확인하는 것이 아니라 불일치가 드러날 자리를 만드는 것이다. 관측이 하나뿐이면 불일치는 구조적으로 발생할 수 없다.
“썼다” 는 모델의 진술, grep 결과는 파일시스템의 진술
카나리아 행(3b Step 3)의 절차는 세 단계였다. PREF-7Q2K 를 MEMORY.md 에 쓰게 하고 → cat -A 와 grep 으로 검증하고 → 새 세션에서 회상시킨다.
가운데 단계가 빠지면 실험이 아니다. 에이전트가 “기록했습니다” 라고 말한 것과 그 바이트가 파일에 들어간 것은 다른 사건이고, 전자는 후자의 증거가 아니다.
cat -A 를 쓴 것도 우연이 아니다. 후행 공백, \r, 줄바꿈 없는 끝, 눈에 안 보이는 유니코드 공백 — 카나리아 문자열이 들어갔는데 매칭이 안 되는 경우는 거의 다 여기서 난다. grep 만 돌리면 “안 들어갔다” 와 “다르게 들어갔다” 를 구분하지 못한다.
카나리아 값을 PREF-7Q2K 처럼 자연어에 절대 안 나올 모양으로 고른 것도 설계다. 흔한 단어를 쓰면 grep 이 다른 줄에 걸려 거짓 양성이 난다.
그런데 마지막 행이 제일 중요하다
표 맨 아래, “부수 효과” 로 적힌 칸이다.
이후 답변이 한국어로 바뀜 — 파일 한 줄이 행동을 바꿈. 그리고 아무도 승인 안 함.
먼저 분명히 할 것. 이건 버그가 아니라 기능이다. 세션 시작에 로드되는 파일이 이후 행동을 규정하는 건 이 계열 도구들의 의도된 설계다. Claude Code 의 CLAUDE.md 도 정확히 같은 모양으로 동작한다 — 세션 시작에 읽히고, 이후 모든 응답의 전제가 된다1.
문제는 동작이 아니라 경로다. 코드 배포에는 PR 이 있고 리뷰가 있고 롤백이 있다. 그런데 에이전트의 인격 파일은 쓰기 한 번으로 끝이고, 그 diff 를 보는 사람이 없고, 언제 바뀌었는지 남지도 않는다. 이번엔 바뀐 게 답변 언어라 눈에 띄었을 뿐이다. 바뀐 게 어떤 요청을 거절할지 였다면 아무도 몰랐을 것이다.
그리고 그 파일에 쓰는 주체가 사람만이 아니다. 에이전트 자신이 쓴다. 에이전트가 읽는 외부 콘텐츠(웹 페이지, 이슈 본문, 메일)가 그 쓰기를 유도할 수 있다면, 그건 OWASP 가 LLM01 로 분류한 프롬프트 인젝션의 영속화된 형태가 된다2. 보통의 인젝션은 그 세션에서 끝나는데, 영속 파일에 착륙한 인젝션은 다음 세션의 전제가 된다. 그리고 다음 세션은 그걸 외부 입력으로 취급하지 않는다 — 자기 자신으로 취급한다.
표에서 이걸 잡아낸 방법이 이미 나와 있다는 게 다행이다. 최소 방어 세 가지는 이 실습에서 그대로 나온다.
- 인격 파일을 git 에 둔다. 그러면 변경이 diff 가 되고 사람이 승인하는 지점이 생긴다.
- 카나리아로 무결성을 잰다. 알려진 문자열이 그대로 있는지, 그리고 없어야 할 줄이 생기지 않았는지 같이 본다.
- 에이전트 자신의 쓰기와 사람의 쓰기를 파일 단위로 분리한다. 섞이면 diff 를 봐도 누가 쓴 줄인지 알 수 없다.
남는 것
표 오른쪽 칸만이 사실이다. 왼쪽 칸은 의도이고, 교재에 적힌 문장은 가설이다.
그리고 이 표가 실제로 발견한 건 교재가 알려준 사실이 아니라 교재에 없던 것 둘이었다 — 보고에만 있던 POLICY.md 한 줄, 그리고 승인 경로 없이 행동이 바뀌는 마지막 행. 검증을 붙이는 값은 대체로 여기서 나온다. 맞는다고 확인하는 게 아니라, 어긋난 자리가 드러나는 것.
References
- 본문의 표와 숫자는 2026-09-20 에 직접 돌려 기록한 본인 실측이다. 표본은 각 항목 1회 관측이며, 재현·일반화된 벤치마크가 아니다.
- OpenClaw · OpenClaw Docs — 실습 대상 플랫폼. 워크스페이스 파일·샌드박스·정책 문서 인용은 같은 날의 자매 글 References 절에 정리돼 있다.
- Manage Claude’s memory — Claude Code Docs — 세션 시작 시 로드되는 지침 파일(
CLAUDE.md)의 공식 설명. 이 글에서는 “영속 파일이 이후 행동의 전제가 된다” 는 설계가 이 계열 도구에 공통이라는 근거로만 인용했다. - LLM01:2025 Prompt Injection — OWASP Top 10 for LLM Applications · 프로젝트 홈
- 같은 날 앞선 글: 에이전트의 영혼은 마크다운이다 · 에이전트가 자기 파일 일곱 개를 설명했다
-
Anthropic, Manage Claude’s memory, Claude Code 문서 (2026-09-20 확인). 이 글의 실습 대상은 OpenClaw 이며,
CLAUDE.md는 동일 제품이 아니라 같은 설계 패턴의 공식 문서화 사례로 인용한 것이다. ↩ -
OWASP GenAI Security Project, LLM01:2025 Prompt Injection (2026-09-20 확인). 본문의 “영속화된 인젝션” 은 표에서 관측된 쓰기 경로에 이 분류를 적용한 내 해석이며, 이번 실습에서 실제 공격을 재현한 것은 아니다. ↩